C++ 提供了很大的工程自由度;如果缺少明确的依赖边界和持续度量,模板、头文件与编译单元的成本很容易随项目规模一起放大。
随着工程规模增大,TiFlash 项目也逐渐开始暴露出这类问题:
头文件凌乱
模板滥用
编译缓慢
工程质量愈发难以控制
本文旨在提供量化指标和参考方法用以优化 C++ 工程项目的编译流程。希望动员社区的力量,一起来优化 TiFlash 的工程质量。
全文包含两条主线:
构建效率 :time trace、模板实例化、头文件依赖、编译单元、PCH、PImpl 和 ccache。产物运行性能 :LTO、PGO、BOLT 和代码大页。这些技术通常会增加构建成本,目标不是缩短日常编译时间。
基础概念 通常,完整的构建流程包括预处理(Preprocessing)、编译(Compilation)、汇编(Assembly)和链接(Linking)。Clang/LLVM 的编译流水线可以大致分为前端(Frontend)和后端(Backend):
前端负责预处理、语法解析、语义分析、模板实例化以及 LLVM IR 生成。Clang time trace 中的 ParseClass、InstantiateClass、InstantiateFunction 和 CodeGen Function 等事件可用于定位相应成本。
后端以 LLVM IR 为输入,执行优化 Pass、指令选择、寄存器分配和机器码生成。常见 Pass 可参考 LLVM’s Analysis and Transform Passes 。
C++ 编译器以源文件为编译单元,基本流程可参考 Phases of translation 。Linux 动态链接库相关整理#Linux-动态库 这篇文章介绍过相关的几个案例(主要偏后端和链接器),可供参考。
除明确标注 GNU ld 或 g++ 的案例外,编译命令默认使用 Clang。TiFlash 实验基于 LLVM 13 和指定版本的 TiFlash;不同编译器版本、优化等级、标准库与硬件环境可能产生不同结果,文中的耗时数据主要用于展示分析方法和相对变化。
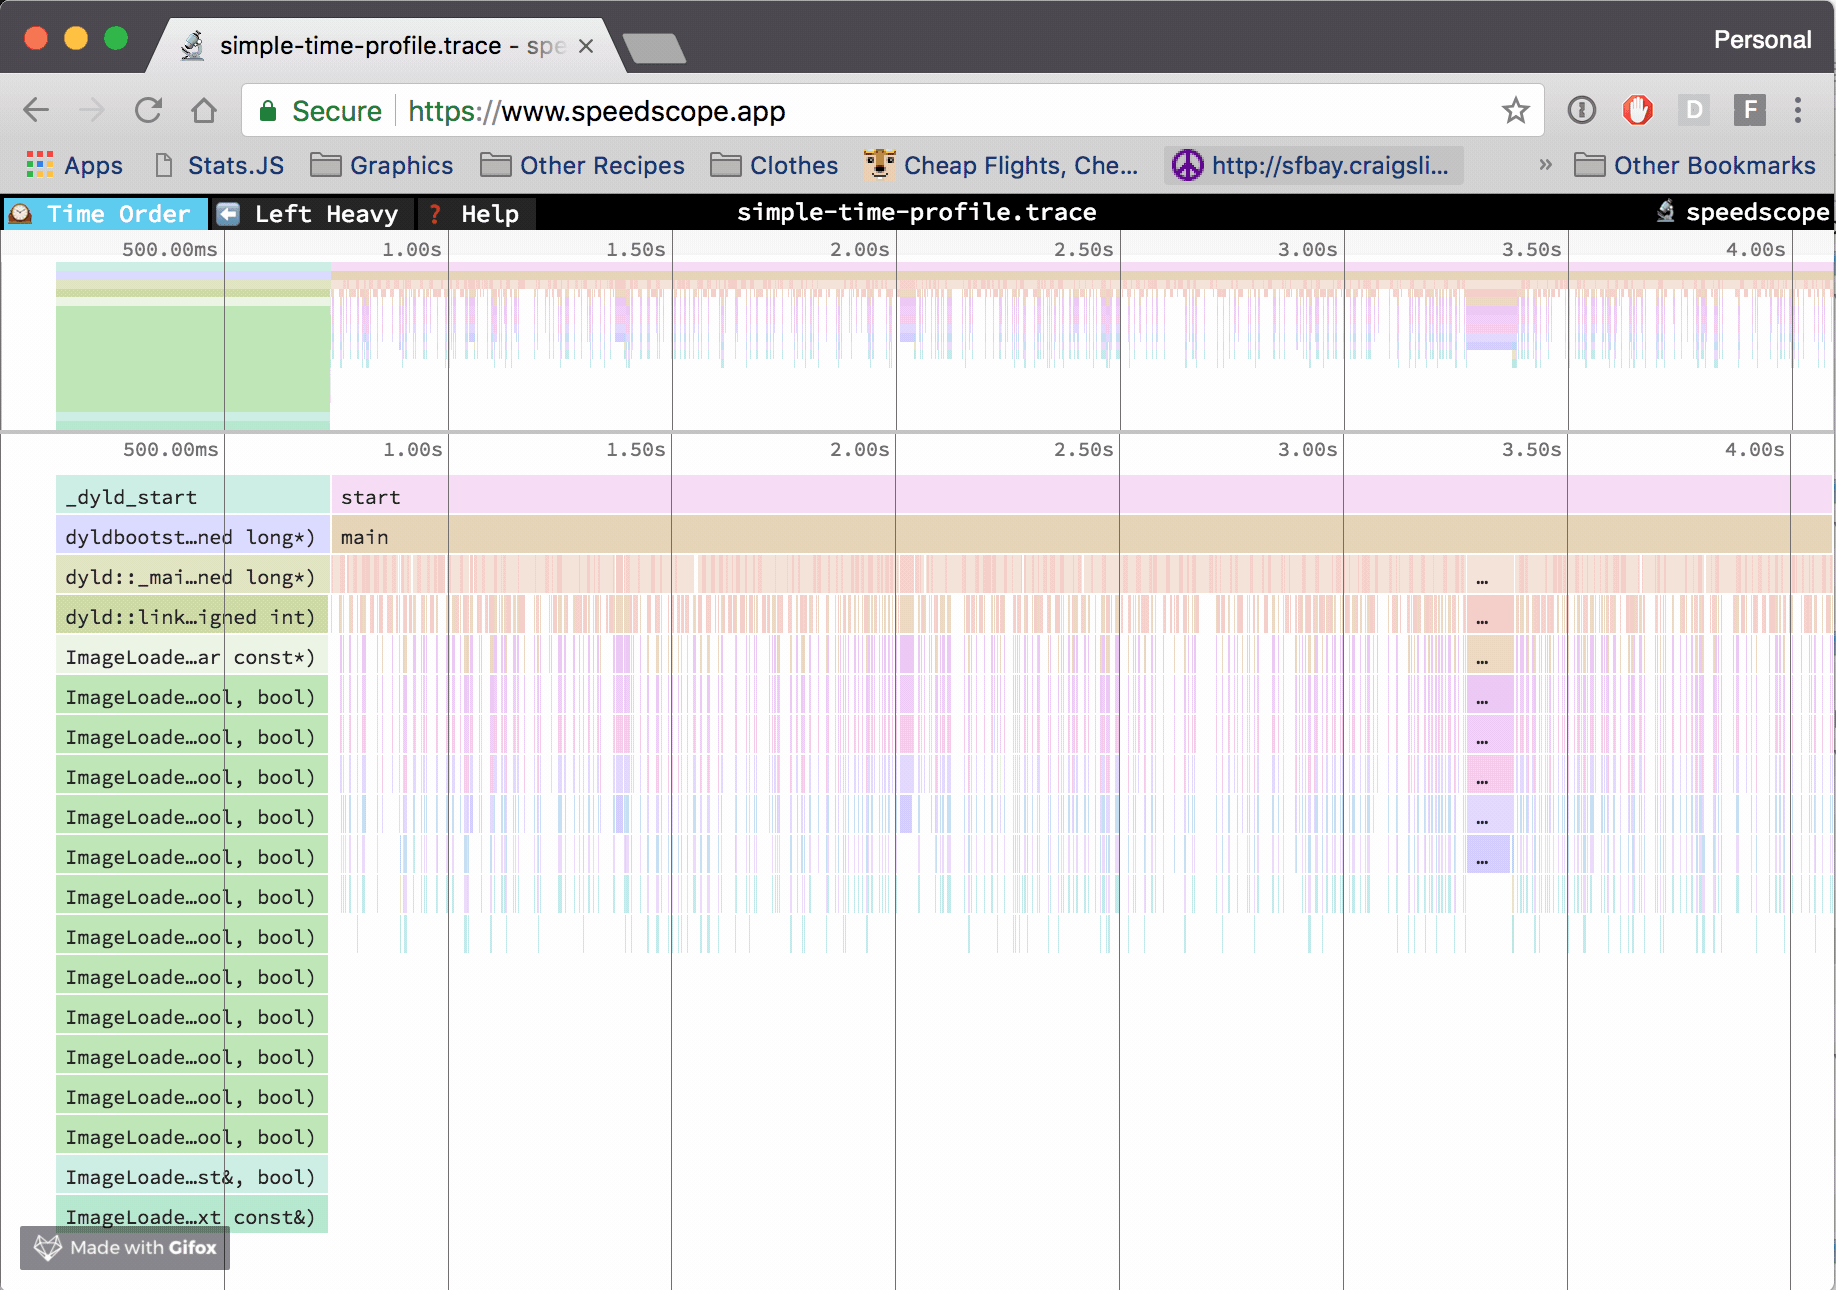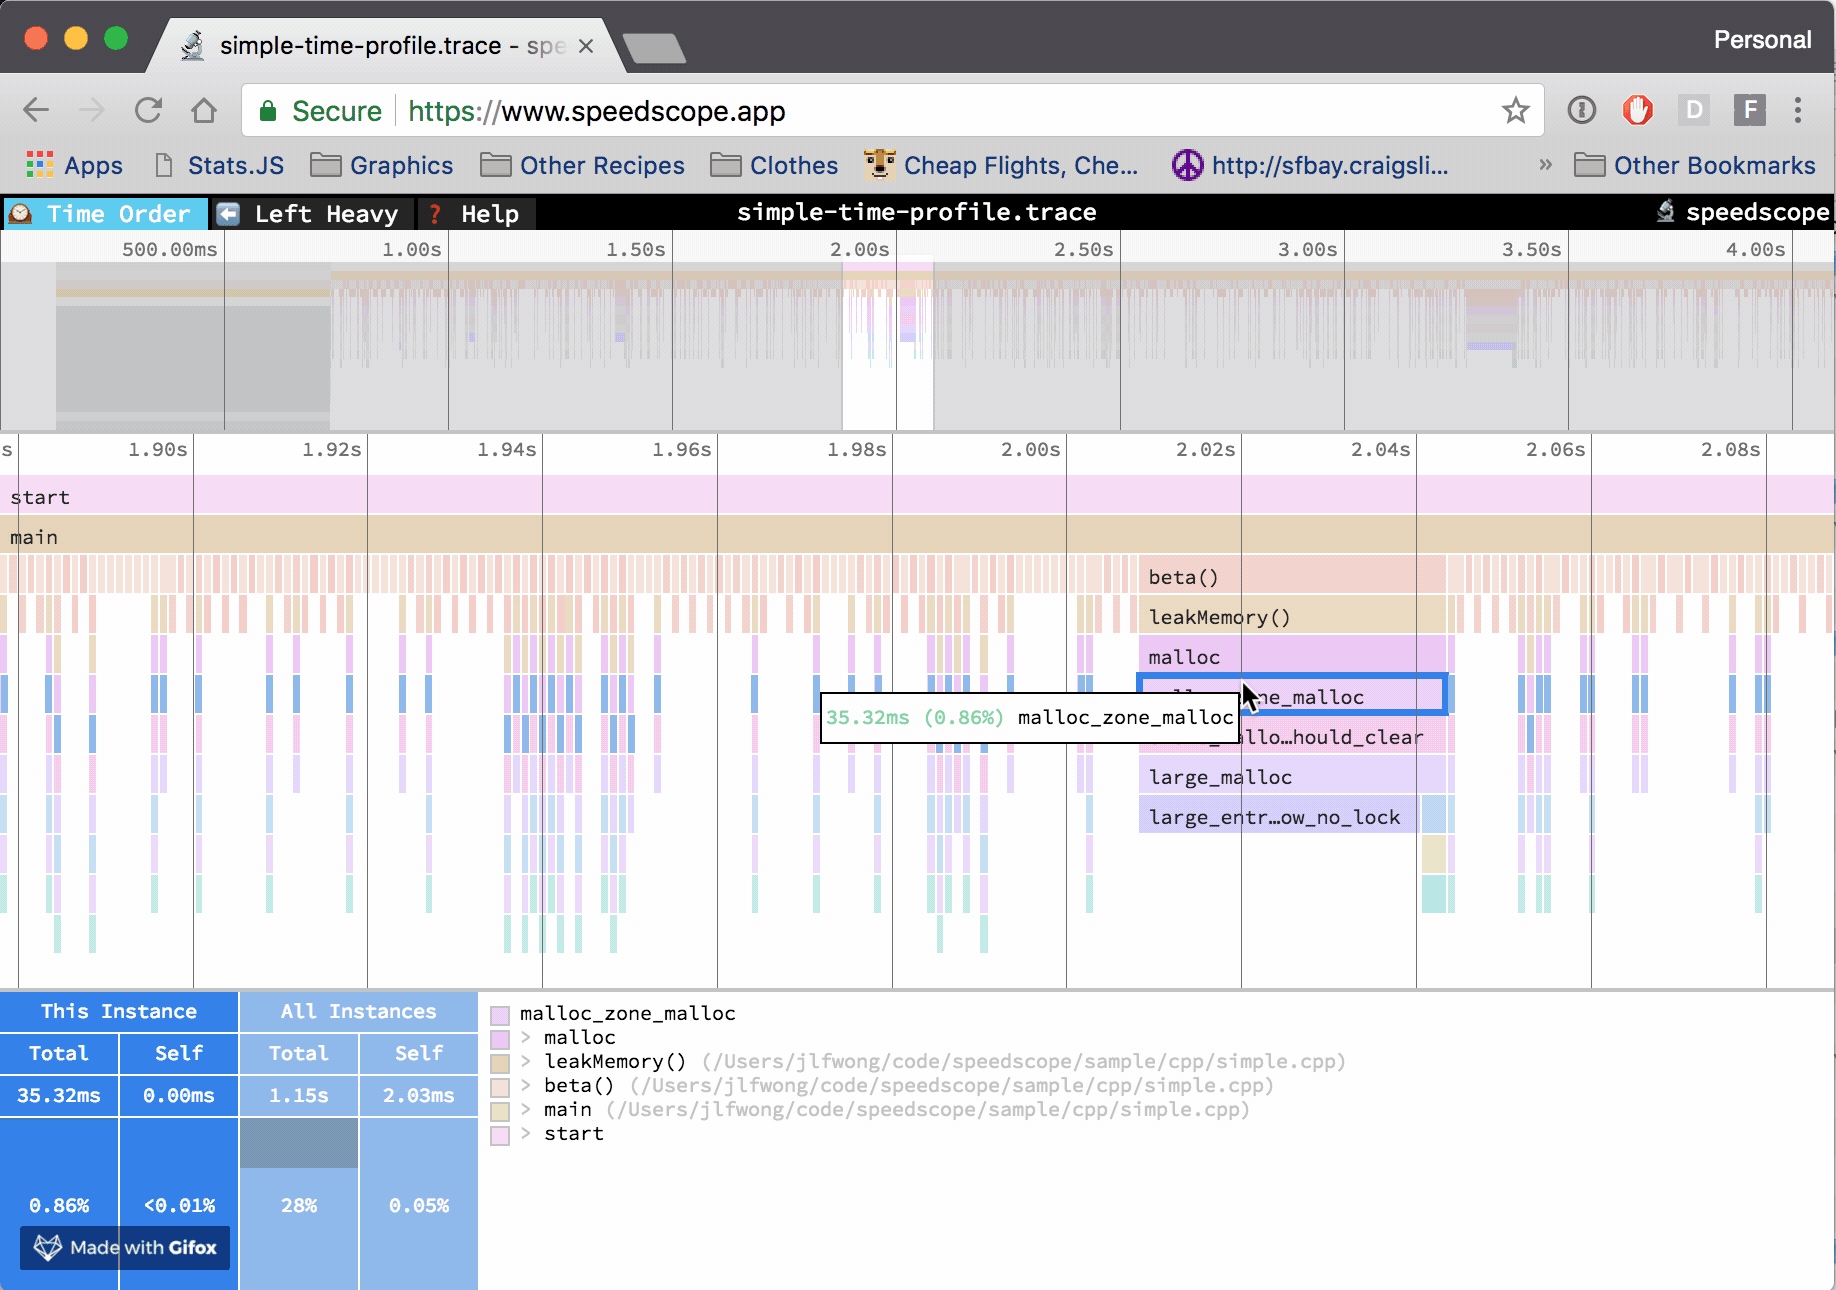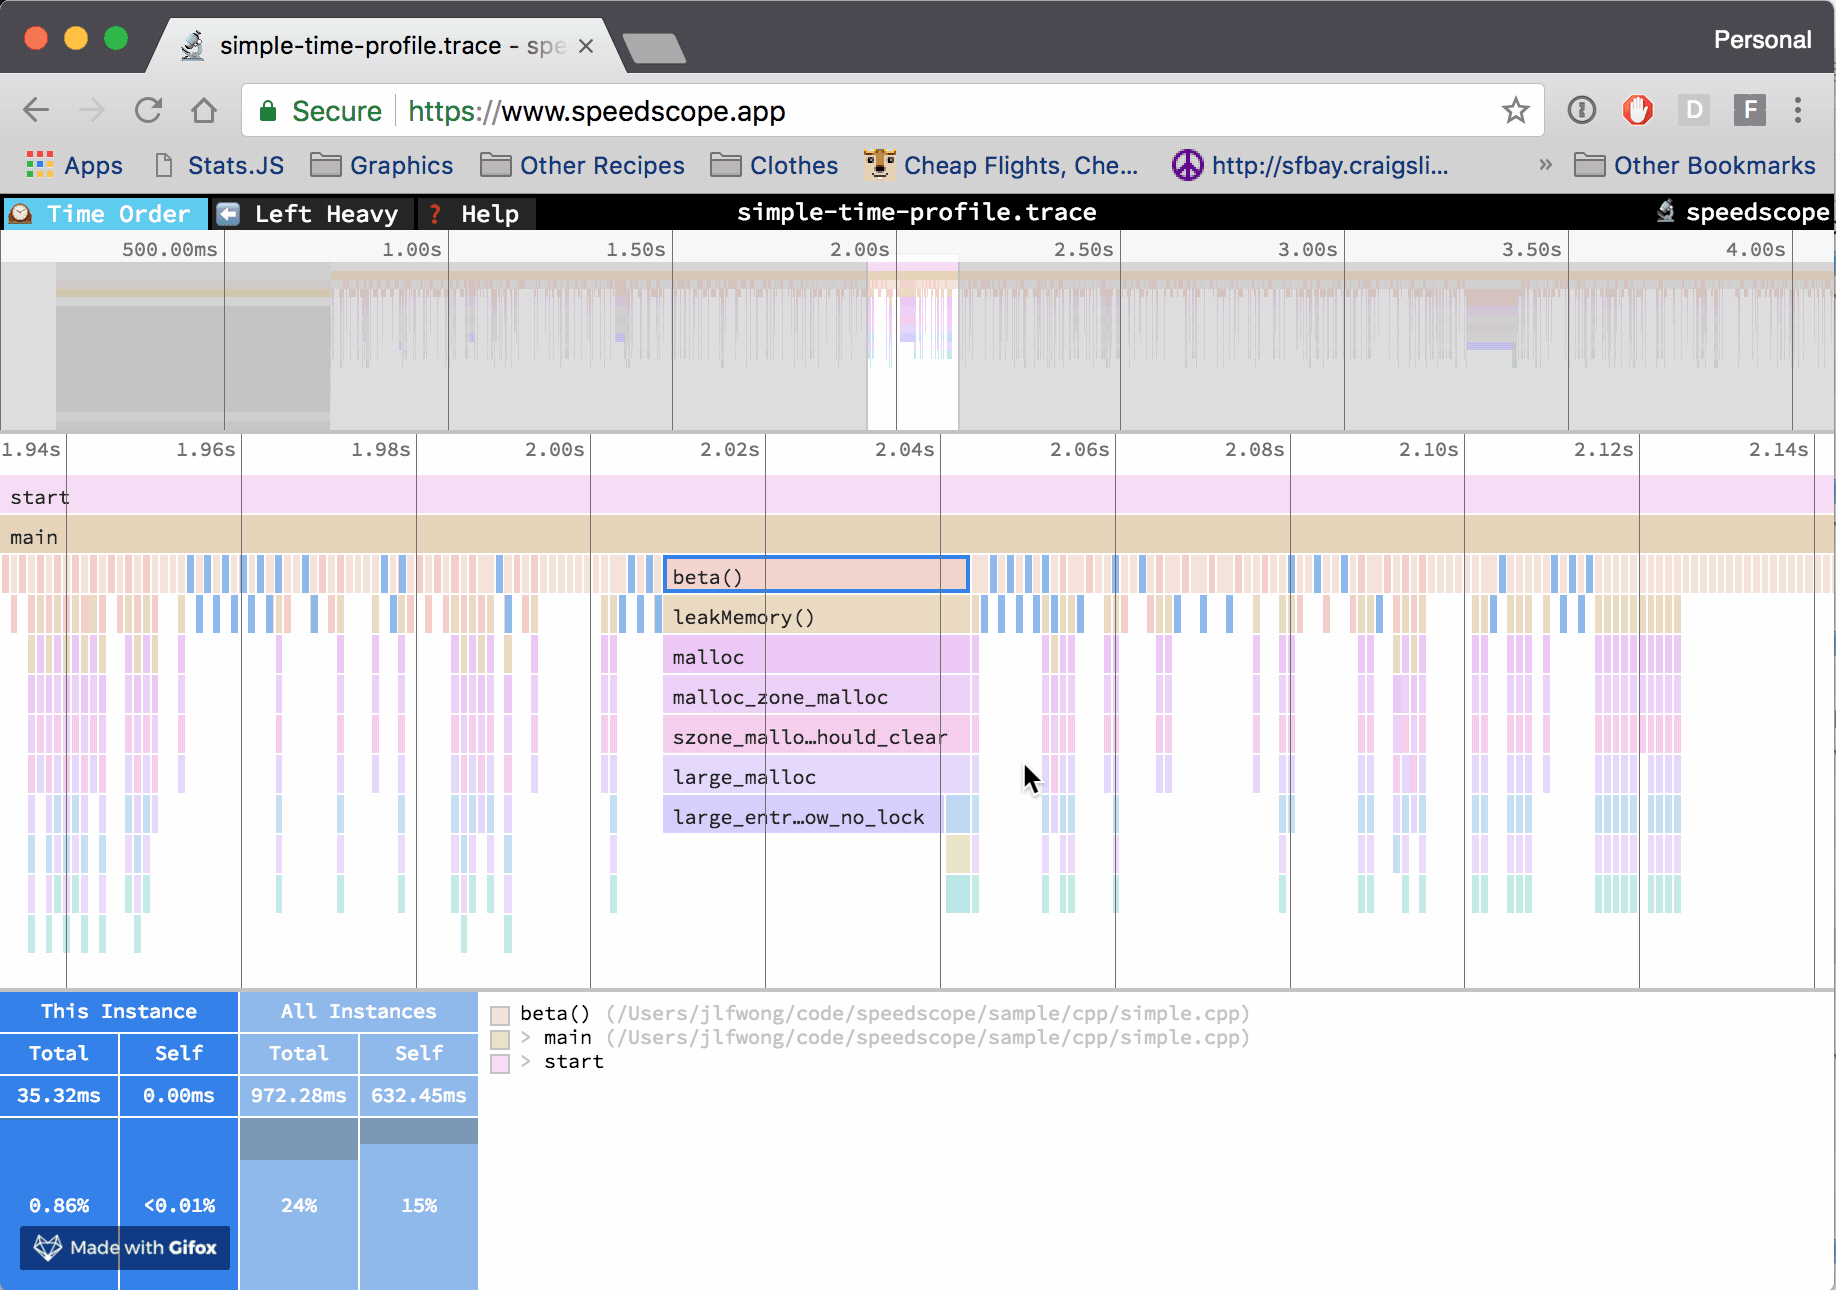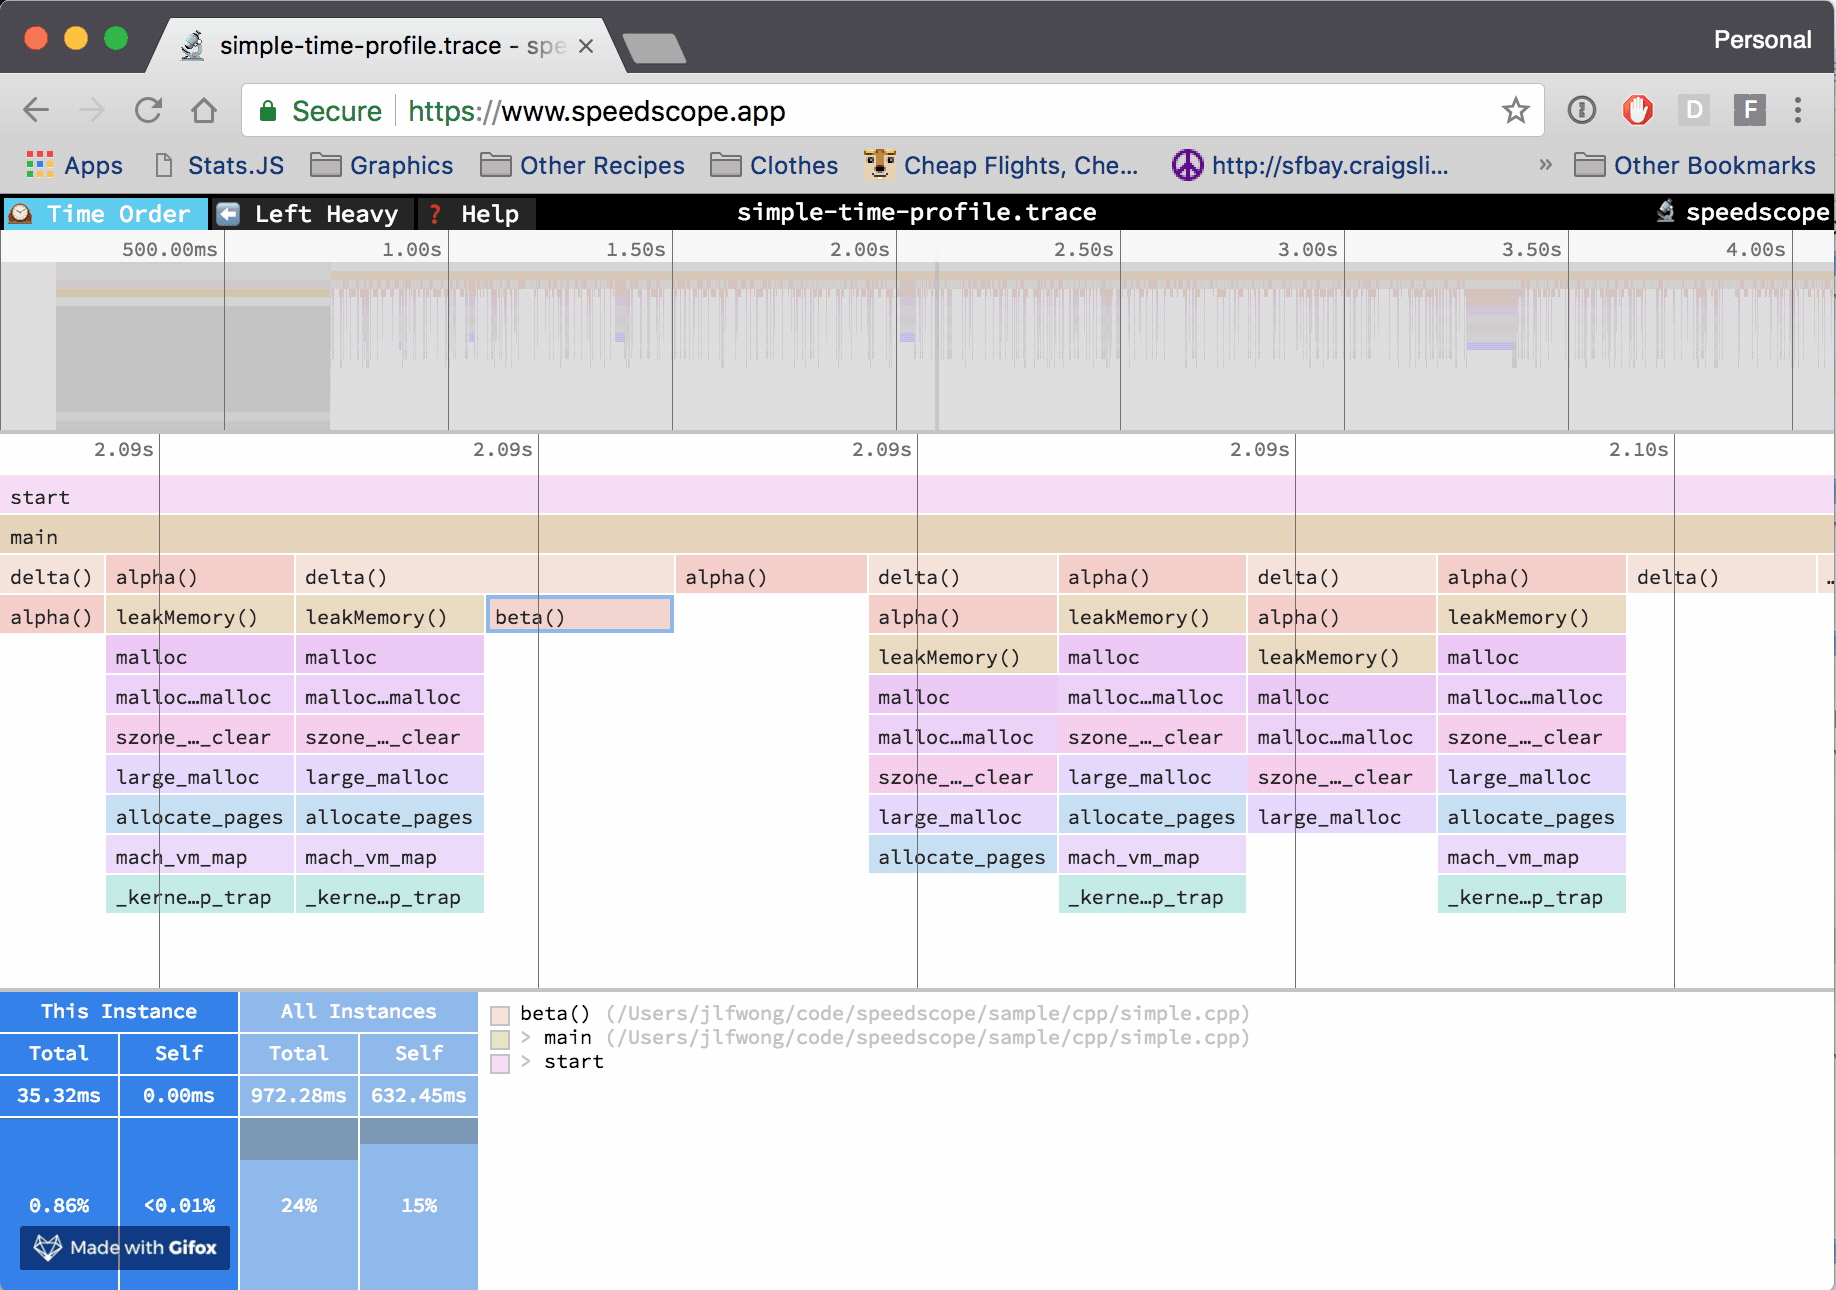
编译流程分析 编译 TiFlash 时加上 CMake 选项 -DENABLE_TIME_TRACES=ON ,即增加 Clang 编译参数 -ftime-trace ,令编译每个目标文件时以 JSON 格式输出相关分析追踪数据。可在 Chromium 系浏览器中打开 chrome://tracing,或使用网站 Speedscope App 查看火焰图。
以这个 commit 的 TiFlash 代码为例 2d234262eb551b04b0ce304c7c6bacac847ca264 。编译完成后,可以在编译路径 ${TIFLASH_BUILD_DIR} 下找到各个目标文件对应的 json 文件,例如 ${TIFLASH_BUILD_DIR}/dbms/src/Functions/CMakeFiles/clickhouse_functions.dir/FunctionsTiDBConversion.cpp.json。根据文章 Aras Pranckevičius - Clang Build Analyzer ,通过工具 ClangBuildAnalyzer 分析 TiFlash 编译过程的各项属性:
1
2
3
4
5
6
git clone https://github.com/aras-p/ClangBuildAnalyzer.git cd ClangBuildAnalyzermake -f projects/make/Makefile tmpfile=$(mktemp /tmp/ClangBuildAnalyzer-capture_file.XXXXXX) ./build/ClangBuildAnalyzer --all ${TIFLASH_BUILD_DIR} ${tmpfile} ./build/ClangBuildAnalyzer --analyze ${tmpfile}
结果如下,前端累计耗时达到 7181.8 秒,高于后端的 6224.5 秒,说明模板实例化和头文件解析可能占据了较高成本,值得进一步分析。以下各个章节将针对此进行分析并简述优化过程。
ClangBuildAnalyzer 分析结果(未优化) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 **** Time summary: Compilation (5485 times): Parsing (frontend): 7181.8 s Codegen & opts (backend): 6224.5 s **** Files that took longest to parse (compiler frontend): 185258 ms: /data2/work/build-llvm-tiflash/dbms/src/Flash/CMakeFiles/flash_service.dir/Coprocessor/DAGExpressionAnalyzerHelper.cpp.o 182847 ms: /data2/work/build-llvm-tiflash/dbms/src/Functions/CMakeFiles/clickhouse_functions.dir/FunctionsTiDBConversion.cpp.o 181468 ms: /data2/work/build-llvm-tiflash/dbms/src/Flash/CMakeFiles/flash_service.dir/Coprocessor/DAGExpressionAnalyzer.cpp.o ... **** Files that took longest to codegen (compiler backend): 406975 ms: /data2/work/build-llvm-tiflash/dbms/src/Functions/CMakeFiles/clickhouse_functions.dir/divide.cpp.o 205837 ms: /data2/work/build-llvm-tiflash/dbms/src/Functions/CMakeFiles/clickhouse_functions.dir/FunctionsComparison.cpp.o 205416 ms: /data2/work/build-llvm-tiflash/dbms/src/Functions/CMakeFiles/clickhouse_functions.dir/FunctionsTiDBConversion.cpp.o 179111 ms: /data2/work/build-llvm-tiflash/dbms/src/Functions/CMakeFiles/clickhouse_functions.dir/modulo.cpp.o 142676 ms: /data2/work/build-llvm-tiflash/dbms/CMakeFiles/dbms.dir/src/Dictionaries/CacheDictionary.cpp.o 133467 ms: /data2/work/build-llvm-tiflash/dbms/src/Functions/CMakeFiles/clickhouse_functions.dir/least.cpp.o 131571 ms: /data2/work/build-llvm-tiflash/dbms/src/Functions/CMakeFiles/clickhouse_functions.dir/greatest.cpp.o ... **** Templates that took longest to instantiate: 247991 ms: DB::FunctionTiDBCast::createWrapper<false> (3 times, avg 82663 ms) 240476 ms: DB::FunctionTiDBCast::createWrapper<true> (3 times, avg 80158 ms) 228596 ms: std::__function::__func<(lambda at /root/work/tiflash/dbms/src/Functions/FunctionsTiDBC... (7200 times, avg 31 ms) 227424 ms: std::__function::__func<(lambda at /root/work/tiflash/dbms/src/Functions/FunctionsTiDBC... (7200 times, avg 31 ms) 194991 ms: std::function<void (DB::Block &, const std::vector<unsigned long> &, unsigned long, bool, const ti... (2400 times, avg 81 ms) 194077 ms: std::function<void (DB::Block &, const std::vector<unsigned long> &, unsigned long, bool, const ti... (2400 times, avg 80 ms) 193740 ms: std::__function::__value_func<void (DB::Block &, const std::vector<unsigned long> &, unsigned long... (2400 times, avg 80 ms) 192884 ms: std::__function::__value_func<void (DB::Block &, const std::vector<unsigned long> &, unsigned long... (2400 times, avg 80 ms) 191873 ms: std::__function::__value_func<void (DB::Block &, const std::vector<unsigned long> &, unsigned long... (2400 times, avg 79 ms) 191093 ms: std::__function::__value_func<void (DB::Block &, const std::vector<unsigned long> &, unsigned long... (2400 times, avg 79 ms) 132499 ms: DB::castTypeToEither<DB::DataTypeNumber<unsigned char>, DB::DataTypeNumber<unsigned short>, DB::Da... (20 times, avg 6624 ms) 132198 ms: DB::castTypeToEither<DB::DataTypeNumber<unsigned char>, DB::DataTypeNumber<unsigned short>, DB::Da... (320 times, avg 413 ms) 131016 ms: std::__function::__alloc_func<(lambda at /root/work/tiflash/dbms/src/Functions/Function... (7200 times, avg 18 ms) 130531 ms: std::__function::__alloc_func<(lambda at /root/work/tiflash/dbms/src/Functions/Function... (7200 times, avg 18 ms) 128066 ms: DB::castTypeToEither<DB::DataTypeNumber<unsigned char>, DB::DataTypeNumber<unsigned short>, DB::Da... (5120 times, avg 25 ms) ... **** Template sets that took longest to instantiate: 734148 ms: std::function<$>::function<$> (9422 times, avg 77 ms) 729456 ms: std::__function::__value_func<$>::__value_func<$> (9422 times, avg 77 ms) 598582 ms: std::__function::__func<$>::__func (9422 times, avg 63 ms) 494799 ms: std::__function::__alloc_func<$>::__alloc_func (28266 times, avg 17 ms) 488467 ms: DB::FunctionTiDBCast::createWrapper<$> (6 times, avg 81411 ms) 419445 ms: DB::FunctionTiDBCast::createWrapperForDecimal<$> (480 times, avg 873 ms) 381118 ms: std::forward_as_tuple<$> (39069 times, avg 9 ms) ... **** Function sets that took longest to compile / optimize: 31177 ms: DB::IAggregateFunctionHelper<$>::addBatchLookupTable8(unsigned long, char**, unsigned long, std::__1::function<$>, unsigned char const*, DB::IColumn const**, DB::Arena*) const (1250 times, avg 24 ms) ... *** Expensive headers: 1091837 ms: /root/work/tiflash/dbms/src/Common/FmtUtils.h (included 750 times, avg 1455 ms), included via: 1022467 ms: /root/work/tiflash/libs/libcommon/include/common/StringRef.h (included 754 times, avg 1356 ms), included via: 985876 ms: /root/work/tiflash/dbms/src/Common/Exception.h (included 748 times, avg 1318 ms), included via: 974680 ms: /root/work/tiflash/dbms/src/Common/StackTrace.h (included 749 times, avg 1301 ms), included via: 681167 ms: /data2/tiflash-env/sysroot/include/c++/v1/string (included 1903 times, avg 357 ms), included via: 501559 ms: /data2/tiflash-env/sysroot/include/c++/v1/algorithm (included 1969 times, avg 254 ms), included via: 498058 ms: /root/work/tiflash/dbms/src/Columns/IColumn.h (included 516 times, avg 965 ms), included via: 422329 ms: /root/work/tiflash/dbms/src/Core/Types.h (included 706 times, avg 598 ms), included via: 405688 ms: /data2/tiflash-env/sysroot/include/c++/v1/functional (included 1971 times, avg 205 ms), included via:
ClangBuildAnalyzer 展示的是各编译任务的累计耗时,不等同于并行构建下的墙钟时间。判断最终收益还应结合 clean build 和增量构建的实际等待时间。
编译优化 当时 TiFlash 使用 LLVM 13 和 LLD 。现有 ClangBuildAnalyzer 数据主要暴露编译前端与后端成本,没有显示链接是主要长尾,因此本文首先关注模板实例化、头文件依赖、编译单元和缓存;若要比较 LLD、GNU ld 或 mold ,仍应单独记录链接阶段的墙钟时间和峰值内存。后文的 LTO 、PGO 与 Post-link Optimizer 则用于提升编译产物的运行性能,代价通常是更大的构建耗时和资源消耗。
就绝大部分实际场景而言(尤其是滥用模板的场景),少生成重复代码,便足以有效减轻后端的负担。
模板
在大型 C++ 项目中,过度使用模板容易放大头文件依赖、重复实例化和代码生成成本,是常见的构建性能瓶颈。
模板实例化 模板在什么时候会被实例化?
案例(1.0) 1 2 3 4 5 6 7 8 #pragma once #include <unordered_map> struct Test1 { std::unordered_map<int , int > d_; }; #include "test1.h"
1 2 clang++ -c test1.cpp -o test1.o -ftime-trace -std=gnu++17 // get test1.json
用浏览器打开 test1.json 查看火焰图可知 std::unordered_map<int, int> 已经被实例化,且属于前端行为 ParseClass。意味着编译包含 test1.h 的源文件时均会产生这一重复行为。
1 2 3 4 InstantiateClass {"detail":"std::__1::unordered_map<int, int, std::__1::hash<int>, std::__1::equal_to<int>, std::__1::allocator<std::__1::pair<const int, int> > >"} > ParseClass {"detail":"Test1"} > Frontend > ExecuteCompiler
对于 test4 和 test5 也是同样效果。
1 2 3 4 5 #include <unordered_map> struct Test4 { template <typename T> std::unordered_map<int , int > test4 (T) {} };
1 2 3 #include <unordered_map> template <typename T> int test5 (T) int , int > s; }
1 2 3 #include <unordered_map> template <typename T> struct Test1 { std::unordered_map<int , int > d_; };
然而,对于下面的 test2,火焰图中却看不到 std::unordered_map<int, int> 被实例化的过程。
1 2 3 4 5 6 7 8 9 #include <unordered_map> struct Test2 { std::unordered_map<int , int > test2 (std::unordered_map<int , int >) ; template <typename T> std::unordered_map<int , int > test2_1 (std::unordered_map<int , int >) ; }; template <typename T>std::unordered_map<int , int > test2_2 (std::unordered_map<int , int >) ;
分析(1.0) 对于编译过程来说 函数 和 变量 本身就是符号,编译器前端推导基于一定的规则。对于上述案例:
test2 只在函数声明的参数和返回类型中使用 std::unordered_map<int, int>,当前编译单元不需要获知该对象的布局,因此没有出现与 test1 相同的完整类实例化事件。
对于 test1/test4/test5/test6,编译器解析类或模板时识别出类模板 std::unordered_map 在结构体或函数实现中被完整定义为 std::unordered_map<int, int> 类型,然后实例化该模板类。
test1:普通类成员对象
test4:成员函数模板的返回值
test5:函数模板中的局部对象
test6:类模板的成员对象
需要重点关注的是 :如 test4/test5/test6 结果所示,即便编译单元最终没有为这些模板生成机器码,编译器仍可能为了完成名称查找、类型检查和其他语义分析而实例化相关声明或定义。这是 C++ 模板定义可见性和语义检查规则带来的编译成本。C++20 的 Modules 可以减少文本式头文件的重复解析,但不能自动消除所有模板实例化成本。目前而言,仍需优化模板定义和头文件依赖,或者参考 PImpl 、PCH 技术。
案例(1.0.1) 以下方案依赖目标类型在特定平台和标准库实现下的大小、对齐方式与对象生命周期规则,维护风险较高。一般应优先使用标准 PImpl;只有在性能测试确认动态分配和间接访问不可接受时,才考虑这种手工不透明存储方案。
类似于 test1.cpp 的场景理论上比较容易用 PImpl 改造。倘若是性能攸关的代码,无法忍受 PImpl 带来的局部性损失,可参考下面的方式,代价就是牺牲代码可读性以及使用模板的便利性。
std::unordered_map<int, int> aka Data令 Test7::Inner 在当前支持的平台和标准库实现下满足目标类型的大小与对齐要求
内存对齐方式(8 Bytes)与 Data 相同(暂不考虑非 64 位平台或其他目标平台)。
在该实验使用的标准库版本中,Data 在 macOS 下是 40 Bytes,在 Linux 下是 56 Bytes;本例中直接取最大值(或可通过宏定义判断编译平台再设置大小),并通过 static_assert 阻止不满足假设的构建。
在源文件中加上 static_assert 以防止其他改动破坏基本假设。
Test7 内部封装构造/析构、以及转换相关接口。当头文件 test7.h 被其他不相干的源文件所包含,编译器前端解析 struct Test7 时则不需要再实例化 std::unordered_map<int, int>。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 #pragma once #include <unordered_map> using Data = std::unordered_map<int , int >;struct Test7 { struct alignas (8 ) Inner { unsigned char bytes[56 ]; }; Data &data () ; const Data &data () const Test7 (); ~Test7 (); Test7 (const Test7 &) = delete ; Test7 &operator =(const Test7 &) = delete ; Test7 (Test7 &&) = delete ; Test7 &operator =(Test7 &&) = delete ; private : Inner data_; };
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 #include "test7.h" #include <new> #include <type_traits> static_assert (sizeof (Test7::Inner) >= sizeof (Data));static_assert (alignof (Test7::Inner) == alignof (Data));Data &Test7::data () { return *std::launder (reinterpret_cast <Data *>(&data_)); } const Data &Test7::data () const return *std::launder (reinterpret_cast <const Data *>(&data_)); } Test7::Test7 () { ::new (static_cast <void *>(&data_)) Data (); } Test7::~Test7 () { static_assert (std::is_destructible_v<Data>); data ().~Data (); }
这里显式删除复制和移动操作,避免按字节复制 Data 后发生重复释放。构造时直接在原始存储地址上 placement new,访问时通过 std::launder 获取已开始生命周期的对象。即便如此,固定的 56 Bytes 和 8 Bytes 对齐仍绑定具体 ABI,只适合作为受严格测试约束的特殊方案。
案例(1.0.2) 类似 test4、test5、test6 的场景,可以将 std::unordered_map<int, int> 从模板实现之处消去,由调用方通过模板参数传入类型。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 struct Test4 { template <typename T, typename MAP> MAP test4 (T) { return {}; } }; template <typename T, typename MAP> int test5 (T) MAP s; (void )s; return 0 ; } template <typename T, typename MAP> struct Test1 { MAP d_; };#include "test8.h" #include <unordered_map> void foo () void , std::unordered_map<int , int >>(); }
案例(1.1) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 #include <cstdint> #include <optional> template <typename V> struct Test9_2 { void foo (bool b) goo <float >() : goo <double >(); } template <typename T> void goo () std::optional<V> v_; }; struct Test9_1 { void foo (bool b) goo <int >() : goo <bool >(); } template <typename T> void koo () goo <std::int64_t >(); Test9_2<char >{}.foo (true ); } template <typename T> void goo () };
test9 中可以看到编译器前端在 PerformPendingInstantiations 阶段,实例化了模板函数 Test9_1::goo<int>,Test9_1::goo<bool>。因为编译器解析普通类成员函数 Test9_1::foo 的实现,至少要推导出这 2 个依赖函数的完整上下文,否则就会失败报错。Test9_1::koo 中调用了其他模板函数 Test9_1::goo<std::int64_t> 和 Test9_2<char>::foo。如果 koo 本身没有实例化,编译器通常不会为这些调用生成代码。对 Test9_2<char> 增加显式实例化定义 template struct Test9_2<char>; 后,才能在该案例的 time trace 中看到 Test9_2<char>::goo<float> 和 Test9_2<char>::goo<double> 的实例化事件。
案例(1.2) test10 中的 struct Test10 同时定义了 3 个成员函数,并 显式 地实现了 Test10::goo,最终只有 Test10::goo 生成了对应的符号和汇编。
1 2 3 4 5 6 7 struct Test10 { int foo () return 2 ; } template <typename ...> int foo2 () return 3 ; } int goo () }; int Test10::goo () return 1 ; }
1 2 3 ➜ clang++ -c test10.cpp -o test10.o -ftime-trace -std=gnu++17 ➜ nm -C test10.o 0000000000000000 T Test10::goo()
当编译单元存在其他函数实现依赖 Test10::foo 和 Test10::foo2<> 时,才会生成相关的符号和汇编。此例中,内联成员函数和模板实例对应的 ELF 符号显示为 W/w(弱符号),链接器可按 C++ ODR/COMDAT 规则合并等价定义。
1 2 3 4 5 6 7 8 struct Test10 { int foo () return 2 ; } template <typename ...> int foo2 () return 3 ; } int goo () }; int Test10::goo () return 1 ; }int koo () return Test10{}.foo () + Test10{}.foo2 (); }
1 2 3 4 5 6 ➜ clang++ -c test10.cpp -o test10.o -ftime-trace -std=gnu++17 ➜ nm -C test10.o 0000000000000010 T koo() 0000000000000000 W Test10::foo() 0000000000000000 T Test10::goo() 0000000000000000 W int Test10::foo2<>()
删减重复模板实例化 案例(2.0) 根据 ClangBuildAnalyzer 分析结果 ,排名靠前的 FunctionsTiDBConversion.cpp,DAGExpressionAnalyzer.cpp,DAGExpressionAnalyzerHelper.cpp 都是重度模板使用者。而且 template <bool return_nullable> WrapperType createWrapper
1 2 3 4 5 6 7 8 9 InstantiateFunction {"detail":"DB::FunctionTiDBCast::createWrapper<true>"} > PerformPendingInstantiations > Frontend > ExecuteCompiler InstantiateFunction {"detail":"DB::FunctionTiDBCast::createWrapper<false>"} > PerformPendingInstantiations > Frontend > ExecuteCompiler
函数的模板参数是一个 bool 类型,全部枚举一遍也就是 2 种情况,共被实例化了 6 次显得很不合理。WHY ?
分析(2) class FunctionTiDBCast 本身也就只在 DB::FunctionBuilderTiDBCast::buildImpl 函数中被创建使用。为了删除多余的模板实例化,一种简单的改动就如 tiflash/pull/4978
将 class FunctionTiDBCast 变成一个模板类 template <typename...> class FunctionTiDBCast
把 DB::FunctionBuilderTiDBCast::buildImpl 的实现挪到源文件 FunctionsTiDBConversion.cpp 中。如此一来,即便其他源文件包含 FunctionsTiDBConversion.h,因为没有实际使用关系也就不会实例化该模板类及其成员函数。
改动效果如下,DAGExpressionAnalyzerHelper.cpp 的前端耗时从 185258 ms 下降到 20012 ms(降幅 89.2%),DAGExpressionAnalyzer.cpp 则是 181468 ms 降到 19898 ms(降幅 89.0%)。模板函数被实例化的次数也符合预期。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 **** Files that took longest to parse (compiler frontend): 188112 ms: /data2/work/build-llvm-tiflash/dbms/src/Functions/CMakeFiles/clickhouse_functions.dir/FunctionsTiDBConversion.cpp.o ... 20012 ms: /data2/work/build-llvm-tiflash/dbms/src/Flash/CMakeFiles/flash_service.dir/Coprocessor/DAGExpressionAnalyzerHelper.cpp.o 19898 ms: /data2/work/build-llvm-tiflash/dbms/src/Flash/CMakeFiles/flash_service.dir/Coprocessor/DAGExpressionAnalyzer.cpp.o **** Files that took longest to codegen (compiler backend): ... 210576 ms: /data2/work/build-llvm-tiflash/dbms/src/Functions/CMakeFiles/clickhouse_functions.dir/FunctionsTiDBConversion.cpp.o ... **** Files that took longest to parse (compiler frontend): ... 85109 ms: DB::FunctionTiDBCast<>::createWrapper<false> (1 times, avg 85109 ms) 84390 ms: DB::FunctionTiDBCast<>::createWrapper<true> (1 times, avg 84390 ms) ... 144093 ms: DB::FunctionTiDBCast<$>::createWrapperForDecimal<$> (160 times, avg 900 ms) ...
PS:理论上把头文件里非模板的实现都挪到源文件中(例如 案例(3.1) ),可以达到相同的效果,现在这种方式无非是代码改动比较小而已。
拆分|合并编译单元 删减重复模板实例化之后,可以发现 divide.cpp 是最大的编译单元,编译器前端耗时 30783 ms,后端 416467 ms。后端耗时主要是编译这 4 个模板类 dbms/src/Functions/divide.cpp#L308-L333 以及其衍生出的template <typename... Ts, typename F> static bool castTypeToEither。巨大的编译单元令每次修改代码均陷入漫长的等待。为了充分利用多核资源,避免单核瓶颈,一种简单的方法就是把这 4 个函数及其相关的模板实例拆分到 4 个源文件中。
事实上之前 TiFlash 代码中注册这类 Function 函数的风格也是继承 Clickhouse,按功能独立拆分成:registerFunctionDivideFloating.cpp、registerFunctionDivideIntegral.cpp、registerFunctionDivideIntegralOrZero.cpp、registerFunctionTiDBDivideFloating.cpp 这 4 个源文件。
是在 92e668158c87893535d812773e4bfa501f0a2dc8 中这些源文件被合并成现在这样巨大的编译单元。
合并源文件所带来的好处包括以下几点:
减少头文件前端处理开销:例如某个头文件被多个源文件包含,每个编译单元都需独立解析一遍。
减少重复编译:与 案例(1.2) 类似,头文件中有函数实现,每个编译单元用到该函数时均会生成相关的符号和汇编。但最终链接器只会为符号绑定一种实现。
利于编译器优化:普通编译优化无法跨编译单元
进一步还可以使用 Unity Build,将若干源文件按批次包含进自动生成的 unity 源文件,减少重复解析开销。CMake 通过 CMAKE_UNITY_BUILD 提供支持,并可用 UNITY_BUILD_BATCH_SIZE 控制每批文件数;默认 batch size 是 8,并非必然把整个目标合成一个编译单元。
Unity Build 能让同一批文件共享编译上下文,但它与 LTO 所处阶段和优化能力不同,不能笼统地说比 LTO“更彻底”。主要代价包括:
减少可并行调度的编译任务;修改一个源文件时,需要重编译它所在的整个 unity batch
需解决静态变量或本地定义重名冲突
编译单元资源内存消耗峰值较大
与 CMAKE_EXPORT_COMPILE_COMMANDS、部分静态分析工具和按文件编译选项配合时可能需要额外处理
就工程实践而言,为了兼顾开发效率,对于编译单元可以适度地拆分/合并。可参考的标准为:
根据 ClangBuildAnalyzer 分析结果中后端编译耗时的前几项,找出明显偏高的单元。
如果某个编译单元后端耗时明显高于其他单元,并且成为并行构建的关键路径,可以考虑按逻辑模块拆分。拆分后需要重新测量墙钟时间,因为更多编译单元也会带来重复的头文件解析成本
对于前端耗时相比于后端较高的模块,则可以按需合并
理想情况下,应避免少数超大编译单元成为并行构建的长尾任务,同时控制拆分带来的重复解析成本
显式实例化 基本概念参考 Explicit instantiation ,核心语法为:
1 2 template class -key template -name < argument-list > ;extern template class -key template -name < argument-list > ;
案例(3.0) extern template 主要用于抑制隐式实例化产生重复代码,并不保证编译器跳过完成语义检查所需的所有实例化工作。此外,声明位置也很重要,通常应在可能触发隐式实例化的使用点之前可见。因此,需要分别通过 time trace 和目标文件符号判断“前端工作是否减少”与“代码是否重复生成”。
下面把显式实例化声明放在调用点之前。这样可以抑制当前编译单元为相应 specialization 生成代码,但模板定义仍需被解析,编译器也仍可能为名称查找和语义检查完成部分实例化工作。因此,应同时检查 time trace 和 nm 输出,不要把“目标文件不再生成定义”等同于“前端完全没有成本”。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 #include <cstdint> #include <map> #include <optional> template <typename ...> struct Test11 { template <typename T> void foo_1 () std::optional<T>{}; doo_1 <T>(); } template <typename T> void doo_1 () }; template <typename T> void doo_2 () template <typename T> void foo_2 () std::optional<T>{}; doo_2 <T>(); } extern template void Test11<>::foo_1 <std::int64_t >();extern template void Test11<>::doo_1 <std::int64_t >();extern template void foo_2 <float >();void goo () Test11{}.foo_1 <std::int64_t >(); foo_2 <float >(); }
1 2 3 4 5 ➜ clang++ -c test11.cpp -o test11.o -ftime-trace -std=gnu++17 ➜ nm -C test11.o 0000000000000000 T goo() U void foo_2<float >() U void Test11<>::foo_1<long long>()
类可采用定义实现分离的方式来达到类似的效果,不过需要注意的是:如果模板函数有被实际用到(例如 test12_2.cpp),需要像 (1) 处在模板函数实现的源文件内显式实例化,否则会出现找不到相关符号的链接错误。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 #pragma once template <typename ...> struct Test12 { template <typename T> void foo_1 () template <typename T> void doo_1 () }; #include "test12_1.h" #include <cstdint> void foo () foo_1 <std::int64_t >(); }#include "test12_1.h" #include <cstdint> #include <map> #include <optional> template <typename ... Args>template <typename T>void Test12<Args...>::foo_1 () { std::optional<T>{}; doo_1 <T>(); } template <typename ... Args>template <typename T>void Test12<Args...>::doo_1 () { std::map<T, T>{}; } template void Test12<>::foo_1 <std::int64_t >();
抽离非模板公共实现 如果类模板中实现了与模板参数无关的函数,可以将这部分逻辑下沉到非模板基类或独立函数,以免每次模板实例化时重复生成代码。这种拆分本身并不自动提供稳定 ABI;若接口需要跨动态库发布,还需单独控制数据布局、符号可见性和版本兼容。
案例(3.1) 每次实例化类模板,编译器均会生成函数 Node<xxx>::foo。如果采用定义实现分离的方式,则需要像 案例(3.0) 显式实例化每个被用到的模板类。
1 2 3 4 5 6 #include <optional> template <typename T> struct Node { void foo () float > _; } T v_; };
将函数分离到非模板基类中,并通过继承复用,则最后只需要生成一份 NodeBase::foo。
1 2 3 4 5 6 7 8 9 10 11 struct NodeBase { void foo () }; #include "test15_base.h" template <typename T> struct Node : NodeBase { T v_; };#include "test15_base.h" #include <optional> void NodeBase::foo () float > _; }
头文件优化 头文件依赖 现有工具:
头文件依赖解耦,可列出说明使用文档和标准,让社区参与。
前向声明 前向声明(Forward declaration )是在尚未给出完整定义时先声明名称和类型。指针、引用和部分函数声明只需不完整类型;按值成员、继承、sizeof、成员访问以及许多模板操作则需要完整定义及其大小、对齐方式等信息。
前向声明对于解耦头文件依赖有较大帮助。然而 Google C++ Style Guide 中却提出 Avoid using forward declarations where possible。比较关键的原因是在某些场景下,前向声明会导致代码静默行为产生变化,例如 案例(4.1) 。
案例(4.0) test13_2.cpp 中使用前向声明 struct Test13_1;,并在 struct Test13_2 的成员函数和成员变量中引用。该源文件可以正常编译。
1 2 3 4 5 6 7 8 struct Test13_1 ;struct Test13_2 { Test13_1 &data; Test13_1 foo (Test13_1) ; }; static_assert (sizeof (Test13_2) == sizeof (void *));static_assert (alignof (Test13_2) == alignof (void *));
分析(4)
成员变量 Test13_2::data 的类型实际是 引用,其内存大小和对齐方式和 指针 相同,编译器解析时并不需要知道 Test13_1 的具体实现。
成员函数 Test13_2::foo 引用了 Test13_1,但编译单元内没有实现该函数,编译器则将其作为一个函数声明(本身也是种前向声明)。
案例(4.1) class B 继承了 class A,如果隐藏类定义,则编译单元 test14.cpp 中 void test_14(B *) 最后会调用 f(void *),如果包含具体定义,在 test14_1.cpp 中则调用 f(A *)。
1 2 3 4 5 6 7 8 9 #include <cstdio> class A ;class B ;void f (A *) void f (void *) void test_14 (B *x) f (x); }
1 2 3 4 5 6 7 8 9 #include <cstdio> class A ;class B ;class A {};class B : public A {};void f (A *) void f (void *) void test_14 (B *x) f (x); }
这个案例中引起不确定性行为的是 C++ 特有的函数重载和类继承方式:
void * 指针可以匹配任意其他指针。test14_1.cpp 中编译器优先按照继承关系匹配,由于不存在 f(B *),则查找顺序为从 f(A *) 到 f(void *)。test14.cpp 中不存在继承关系,且不存在 f(B *),则直接匹配到 f(void *)。
解决这个案例中的问题,可参考以下途径:
去掉 f(void *) 函数,令编译时直接报错,由开发者排查并补上继承关系。
绝大部分实际应用中,比较常见的是子类继承并重写基类的虚函数,用 void * 兜底很难说有什么实际意义。
在 f(void *) 的逻辑实现中直接抛异常或手动 panic。
在代码设计和审查环节应当注意避开这类问题而非一味禁止使用前向声明。
预编译头文件(PCH) Precompiled header (简称 PCH):预编译(C 或 C++)头文件,使之被编译成编译器可以更快处理的中间形式,使用预编译头文件可以显著减少编译时间(主要是前端)。CMake 中支持 PCH 的命令为 target_precompile_headers 。
在 Windows 系统下用 Visual Studio 开发桌面软件时经常能看到头文件 stdafx.h,里面基本会包含开发所用的重型 API。
参考 模板实例化 章节中的几个案例,编译器解析头文件会有不小的开销(尤其涉及到模板实例化),对于 TiFlash 这种 C++ 项目也是个不可忽略的问题。
案例(4.2) 根据 ClangBuildAnalyzer 分析结果 ,Expensive headers 中包含不少公共模块和 STL 库的头文件。5847f1c235b996eb6fb970029da926909e1819fd 为相关库编译选项加上 PCH:
pch-common.h 包含 Exception.h,FmtUtils.h,StackTrace.h 之类的公共模块头文件pch-stl.h 包含常用的 STL 库头文件,例如 algorithm,string,vector,functional 等pch-kvpb.h 包含比较重型的 gRPC 相关头文件
优化后,分析结果显示前端总耗时和重型头文件解析耗时显著下降。
1 2 3 4 5 6 7 8 9 10 11 12 13 **** Time summary: Compilation (5487 times): Parsing (frontend): 4167.5 s ... *** Expensive headers: 188125 ms: /data2/work/tiflash/dbms/src/Columns/IColumn.h (included 515 times, avg 365 ms), included via: ... 178572 ms: /data2/work/tiflash/dbms/src/Common/Decimal.h (included 657 times, avg 271 ms), included via: ... 122002 ms: /data2/work/tiflash/dbms/src/Core/Block.h (included 416 times, avg 293 ms), included via: ...
PImpl PImpl(Pointer to implementation )又称编译防火墙(Compilation firewall)。在类定义中隐藏数据结构的实现细节,只对外暴露不透明的指针/引用/其他固定类型作为访问入口。
例如发布二进制库给第三方时,可用 PImpl 隔离私有数据结构变化并降低 ABI 波动
PImpl 的劣势包括以下几点,如有必要可参考 案例(1.0.1) 来优化
常见的指针式 PImpl 需要一次额外动态分配
存取变量时增加一次间接寻址,对于看重 CPU Cache 和数据局部性的场景不利
案例(5.0) 根据 ClangBuildAnalyzer 结果,有关 struct TiFlashError 的几个模板实例化总开销不小。
1 2 3 4 5 6 7 8 **** Templates that took longest to instantiate: ... 53692 ms: std::optional<DB::TiFlashError> (663 times, avg 80 ms) ... 47327 ms: std::map<std::pair<std::string, std::string>, DB::TiFlashError> (663 times, avg 71 ms) 24149 ms: std::__rebind_alloc_helper<std::allocator_traits<std::allocator<std::pair<const std::pair<std::string, std::string>, DB::TiFlashError>>>, std::__value_type<std::pair<std::string, std::string>, DB::TiFlashError>> (663 times, avg 36 ms) 23596 ms: std::allocator_traits<std::allocator<std::pair<const std::pair<std::string, std::string>, DB::TiFlashError>>> (663 times, avg 35 ms) 22289 ms: std::__value_type<std::pair<std::string, std::string>, DB::TiFlashError> (663 times, avg 33 ms)
使用这些模板的地方主要在 class TiFlashErrorRegistry 。这种把成员函数实现直接放在头文件里的做法 不值得提倡 ,因为包含其的源文件均会解析并实例化涉及到的模板,建议分离定义和实现。std::map<std::pair<std::string, std::string>, TiFlashError> all_errors 则需要多加考量。
头文件中分离函数实现后,只要编译单元内没有其他符号对函数有依赖关系,编译器就可以不实例化函数涉及到的模板
对于类定义,编译器会解析其成员变量和依赖以确定大小和对齐方式。
分析上下文信息可知这个类主要以 单例 的形式用来维护/查找预设数据,可以使用 PImpl 改造以降低前端开销(对于该类的使用场景几乎不会有性能影响)。本案例中类重构效果如TiFlashException.h#L192-L225 。改造完成后,上面提到的模板实例化开销均被消除。std::unique_ptr 也是同样原理,例如 KVStore.h 的改动。
LTO(Link Time Optimization) 前文主要关注构建效率。从本节开始,讨论重点转为编译产物的运行性能。LTO 和 PGO 通常会增加编译或链接成本,其目标不是缩短开发构建时间,而是通过跨模块信息或运行时 profile 生成性能更好的二进制文件。
链接时优化(Link Time Optimization )是比较典型的后端优化,属于 Interprocedural optimization 。LLVM 提供了强大的链接时跨模块优化功能,以获取更好的运行时性能。
ThinLTO 是面向可扩展性设计的 LTO 模式。传统 Full LTO 将输入合并为单一大模块,时间和内存扩展性通常较差;ThinLTO 则令 bitcode 额外携带模块摘要(compact summary),链接器先合并摘要索引,再并行执行跨模块导入和后端优化。
ThinLTO 支持增量缓存,但需要显式配置 linker。例如 ELF lld 可增加 -Wl,--thinlto-cache-dir=<cache-dir>;如果没有启用 cache,不能仅凭 -flto=thin 就假设增量链接会复用此前的后端结果。
tiflash/pull/4890 中加入了 CMake 选项 ENABLE_THINLTO 并在 release build 流程中启用。跨模块优化的好处有以下几点:
全局优化:去虚拟化(whole-program devirtualization),跨模块函数内联
删减无用代码
把函数直接实现在头文件中可以向普通编译暴露函数体,但也会放大依赖和重复编译成本。LTO 能为定义/实现分离后的函数提供跨模块内联和去虚拟化机会,因此可以降低二者之间的矛盾;不过是否真正优化仍受符号可见性、DSO/插件边界、优化预算和调用特征影响,不能视为保证。
案例(6.0) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 int goo (int x) if (x > 0 ) return x * 10 ; else return x / 10 ; } int &get (int *data, int idx) return data[idx]; }bool check (int i, int len) return i < len; }struct Base { virtual void joo () virtual int foo (int x) }; void Base::joo () int Base::foo (int x) return x + 1 ; }int doo (int x, Base &d) return 2 + d.foo (x); }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 int goo (int x) __attribute__((noinline)) int foo (int x) if (x > 0 ) return goo (x) * 10 ; else return goo (x) / 10 ; } int &get (int *data, int idx) bool check (int i, int len) __attribute__((noinline)) void sum (int *a, int *b, int *c, int len) for (int i = 0 ; check (i, len); ++i) get (c, i) = get (a, i) + get (b, i); } struct Base { virtual void joo () virtual int foo (int x) }; int doo (int x, Base &d) struct Impl : Base { int foo (int x) override return x + 4 ; } }; __attribute__((noinline)) int koo (int x) Impl tt{}; return doo (x, tt); }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 int foo (int x) void sum (int *a, int *b, int *c, int len) int koo (int x) int main () int a[] = {1 }; int b[] = {2 }; int c[] = {0 }; const int foo_result = foo (123 ); sum (a, b, c, 1 ); const int koo_result = koo (0 ); return foo_result == 12300 && c[0 ] == 3 && koo_result == 6 ? 0 : 1 ; }
这里给 foo、sum 和 koo 增加 noinline,只是为了让两个版本都保留可供 objdump 对比的顶层函数;它不会阻止 LTO 把 goo、get、check 和虚调用目标优化进这些函数。
下面两组汇编保留的是原文 LLVM 13、x86-64 环境中的历史输出。指令地址、寄存器分配和向量化展开会随 LLVM、目标 CPU、PIE 和链接器版本变化,阅读时应关注跨模块调用是否消失以及语义是否被简化,而不是逐字匹配地址和指令序列。
未启用 LTO 时,编译器仍会执行编译单元内部优化,但无法看到其他源文件中的函数体,因此 foo、sum 和 koo 中保留了跨模块调用。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 clang++ -O3 -DNDEBUG -std=gnu++17 -o t1.o -c t1.cpp clang++ -O3 -DNDEBUG -std=gnu++17 -o t2.o -c t2.cpp clang++ -O3 -DNDEBUG -std=gnu++17 -o t3.o -c t3.cpp clang++ -O3 -DNDEBUG -fuse-ld=lld t1.o t2.o t3.o -o test objdump -d test 00000000002019e0 <_Z3dooiR4Base>: 2019e0: 50 push %rax 2019e1: 89 f8 mov %edi,%eax 2019e3: 48 8b 0e mov (%rsi),%rcx 2019e6: 48 89 f7 mov %rsi,%rdi 2019e9: 89 c6 mov %eax,%esi 2019eb: ff 51 08 callq *0x8(%rcx) 2019ee: 83 c0 02 add $0x2 ,%eax 2019f1: 59 pop %rcx 2019f2: c3 retq 0000000000201a00 <_Z3fooi>: 201a00: 53 push %rbx 201a01: 89 fb mov %edi,%ebx 201a03: e8 78 ff ff ff callq 201980 <_Z3gooi> 201a08: 85 db test %ebx,%ebx 201a0a: 7e 07 jle 201a13 <_Z3fooi+0x13> 201a0c: 01 c0 add %eax,%eax 201a0e: 8d 04 80 lea (%rax,%rax,4),%eax 201a11: 5b pop %rbx 201a12: c3 retq 201a13: 48 98 cltq 201a15: 48 69 c0 67 66 66 66 imul $0x66666667 ,%rax,%rax 201a1c: 48 89 c1 mov %rax,%rcx 201a1f: 48 c1 e9 3f shr $0x3f ,%rcx 201a23: 48 c1 f8 22 sar $0x22 ,%rax 201a27: 01 c8 add %ecx,%eax 201a29: 5b pop %rbx 201a2a: c3 retq 201a2b: 0f 1f 44 00 00 nopl 0x0(%rax,%rax,1) 0000000000201a30 <_Z3sumPiS_S_i>: 201a30: 55 push %rbp 201a31: 41 57 push %r15 201a33: 41 56 push %r14 201a35: 41 55 push %r13 201a37: 41 54 push %r12 201a39: 53 push %rbx 201a3a: 50 push %rax 201a3b: 41 89 cd mov %ecx,%r13d 201a3e: 49 89 d6 mov %rdx,%r14 201a41: 49 89 f7 mov %rsi,%r15 201a44: 49 89 fc mov %rdi,%r12 201a47: 31 ed xor %ebp,%ebp 201a49: 31 ff xor %edi,%edi 201a4b: 89 ce mov %ecx,%esi 201a4d: e8 5e ff ff ff callq 2019b0 <_Z5checkii> 201a52: 84 c0 test %al,%al 201a54: 74 3f je 201a95 <_Z3sumPiS_S_i+0x65> 201a56: 66 2e 0f 1f 84 00 00 nopw %cs:0x0(%rax,%rax,1) 201a5d: 00 00 00 201a60: 4c 89 e7 mov %r12,%rdi 201a63: 89 ee mov %ebp,%esi 201a65: e8 36 ff ff ff callq 2019a0 <_Z3getPii> 201a6a: 8b 18 mov (%rax),%ebx 201a6c: 4c 89 ff mov %r15,%rdi 201a6f: 89 ee mov %ebp,%esi 201a71: e8 2a ff ff ff callq 2019a0 <_Z3getPii> 201a76: 03 18 add (%rax),%ebx 201a78: 4c 89 f7 mov %r14,%rdi 201a7b: 89 ee mov %ebp,%esi 201a7d: e8 1e ff ff ff callq 2019a0 <_Z3getPii> 201a82: 89 18 mov %ebx,(%rax) 201a84: 83 c5 01 add $0x1 ,%ebp 201a87: 89 ef mov %ebp,%edi 201a89: 44 89 ee mov %r13d,%esi 201a8c: e8 1f ff ff ff callq 2019b0 <_Z5checkii> 201a91: 84 c0 test %al,%al 201a93: 75 cb jne 201a60 <_Z3sumPiS_S_i+0x30> 201a95: 48 83 c4 08 add $0x8 ,%rsp 201a99: 5b pop %rbx 201a9a: 41 5c pop %r12 201a9c: 41 5d pop %r13 201a9e: 41 5e pop %r14 201aa0: 41 5f pop %r15 201aa2: 5d pop %rbp 201aa3: c3 retq 201aa4: 66 2e 0f 1f 84 00 00 nopw %cs:0x0(%rax,%rax,1) 201aab: 00 00 00 201aae: 66 90 xchg %ax,%ax 0000000000201ab0 <_Z3kooi>: 201ab0: 50 push %rax 201ab1: 48 c7 04 24 f8 05 20 movq $0x2005f8 ,(%rsp) 201ab8: 00 201ab9: 48 89 e6 mov %rsp,%rsi 201abc: e8 1f ff ff ff callq 2019e0 <_Z3dooiR4Base> 201ac1: 59 pop %rcx 201ac2: c3 retq
启用 LTO 后
foo 函数逻辑直接被优化成等效于 if (x > 0) return x * 100; else return x / 100; 的实现sum 中自动向量化生成 SIMD 指令koo 去虚拟化实现等效于 x + 6 的逻辑
下面的 -fvisibility=hidden、-fvisibility-inlines-hidden 和 -fwhole-program-vtables 适合这个封闭的可执行文件实验,但会改变符号可见性和 whole-program 假设。共享库、插件或需要稳定导出 ABI 的目标不能直接照搬,应先配置导出符号并确认跨 DSO 边界。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 clang++ -flto=thin -fvisibility=hidden -fvisibility-inlines-hidden -fwhole-program-vtables -fsplit-lto-unit -O3 -DNDEBUG -std=gnu++17 -o t1.o -c t1.cpp clang++ -flto=thin -fvisibility=hidden -fvisibility-inlines-hidden -fwhole-program-vtables -fsplit-lto-unit -O3 -DNDEBUG -std=gnu++17 -o t2.o -c t2.cpp clang++ -flto=thin -fvisibility=hidden -fvisibility-inlines-hidden -fwhole-program-vtables -fsplit-lto-unit -O3 -DNDEBUG -std=gnu++17 -o t3.o -c t3.cpp clang++ -flto=thin -fvisibility=hidden -fvisibility-inlines-hidden -fwhole-program-vtables -fsplit-lto-unit -O3 -DNDEBUG -fuse-ld=lld -pthread -flto=thin -flto-jobs=0 -Wl,--thinlto-cache-dir=.thinlto-cache -fvisibility=hidden -fvisibility-inlines-hidden -fwhole-program-vtables -fsplit-lto-unit t1.o t2.o t3.o -o test objdump -d test 00000000002019f0 <_Z3fooi>: 2019f0: 85 ff test %edi,%edi 2019f2: 7e 04 jle 2019f8 <_Z3fooi+0x8> 2019f4: 6b c7 64 imul $0x64 ,%edi,%eax 2019f7: c3 retq 2019f8: f7 df neg %edi 2019fa: 48 69 c7 1f 85 eb 51 imul $0x51eb851f ,%rdi,%rax 201a01: 48 c1 e8 25 shr $0x25 ,%rax 201a05: f7 d8 neg %eax 201a07: c3 retq 0000000000201a10 <_Z3sumPiS_S_i>: 201a10: 85 c9 test %ecx,%ecx 201a12: 0f 8e 7f 01 00 00 jle 201b97 <_Z3sumPiS_S_i+0x187> 201a18: 41 89 c8 mov %ecx,%r8d 201a1b: 83 f9 08 cmp $0x8 ,%ecx 201a1e: 73 7b jae 201a9b <_Z3sumPiS_S_i+0x8b> 201a20: 31 c9 xor %ecx,%ecx 201a22: 49 89 c9 mov %rcx,%r9 201a25: 49 f7 d1 not %r9 201a28: 4d 01 c1 add %r8,%r9 201a2b: 4d 89 c2 mov %r8,%r10 201a2e: 49 83 e2 03 and $0x3 ,%r10 201a32: 74 1f je 201a53 <_Z3sumPiS_S_i+0x43> 201a34: 66 2e 0f 1f 84 00 00 nopw %cs:0x0(%rax,%rax,1) 201a3b: 00 00 00 201a3e: 66 90 xchg %ax,%ax 201a40: 8b 04 8e mov (%rsi,%rcx,4),%eax 201a43: 03 04 8f add (%rdi,%rcx,4),%eax 201a46: 89 04 8a mov %eax,(%rdx,%rcx,4) 201a49: 48 83 c1 01 add $0x1 ,%rcx 201a4d: 49 83 c2 ff add $0xffffffffffffffff ,%r10 201a51: 75 ed jne 201a40 <_Z3sumPiS_S_i+0x30> 201a53: 49 83 f9 03 cmp $0x3 ,%r9 201a57: 0f 82 3a 01 00 00 jb 201b97 <_Z3sumPiS_S_i+0x187> 201a5d: 0f 1f 00 nopl (%rax) 201a60: 8b 04 8e mov (%rsi,%rcx,4),%eax 201a63: 03 04 8f add (%rdi,%rcx,4),%eax 201a66: 89 04 8a mov %eax,(%rdx,%rcx,4) 201a69: 8b 44 8e 04 mov 0x4(%rsi,%rcx,4),%eax 201a6d: 03 44 8f 04 add 0x4(%rdi,%rcx,4),%eax 201a71: 89 44 8a 04 mov %eax,0x4(%rdx,%rcx,4) 201a75: 8b 44 8e 08 mov 0x8(%rsi,%rcx,4),%eax 201a79: 03 44 8f 08 add 0x8(%rdi,%rcx,4),%eax 201a7d: 89 44 8a 08 mov %eax,0x8(%rdx,%rcx,4) 201a81: 8b 44 8e 0c mov 0xc(%rsi,%rcx,4),%eax 201a85: 03 44 8f 0c add 0xc(%rdi,%rcx,4),%eax 201a89: 89 44 8a 0c mov %eax,0xc(%rdx,%rcx,4) 201a8d: 48 83 c1 04 add $0x4 ,%rcx 201a91: 49 39 c8 cmp %rcx,%r8 201a94: 75 ca jne 201a60 <_Z3sumPiS_S_i+0x50> 201a96: e9 fc 00 00 00 jmpq 201b97 <_Z3sumPiS_S_i+0x187> 201a9b: 4a 8d 0c 82 lea (%rdx,%r8,4),%rcx 201a9f: 4a 8d 04 87 lea (%rdi,%r8,4),%rax 201aa3: 48 39 d0 cmp %rdx,%rax 201aa6: 41 0f 97 c2 seta %r10b 201aaa: 4a 8d 04 86 lea (%rsi,%r8,4),%rax 201aae: 48 39 f9 cmp %rdi,%rcx 201ab1: 41 0f 97 c3 seta %r11b 201ab5: 48 39 d0 cmp %rdx,%rax 201ab8: 0f 97 c0 seta %al 201abb: 48 39 f1 cmp %rsi,%rcx 201abe: 41 0f 97 c1 seta %r9b 201ac2: 31 c9 xor %ecx,%ecx 201ac4: 45 84 da test %r11b,%r10b 201ac7: 0f 85 55 ff ff ff jne 201a22 <_Z3sumPiS_S_i+0x12> 201acd: 44 20 c8 and %r9b,%al 201ad0: 0f 85 4c ff ff ff jne 201a22 <_Z3sumPiS_S_i+0x12> 201ad6: 44 89 c1 mov %r8d,%ecx 201ad9: 83 e1 f8 and $0xfffffff8 ,%ecx 201adc: 48 8d 41 f8 lea -0x8(%rcx),%rax 201ae0: 49 89 c1 mov %rax,%r9 201ae3: 49 c1 e9 03 shr $0x3 ,%r9 201ae7: 49 83 c1 01 add $0x1 ,%r9 201aeb: 48 85 c0 test %rax,%rax 201aee: 0f 84 a4 00 00 00 je 201b98 <_Z3sumPiS_S_i+0x188> 201af4: 4d 89 ca mov %r9,%r10 201af7: 49 83 e2 fe and $0xfffffffffffffffe ,%r10 201afb: 49 f7 da neg %r10 201afe: 31 c0 xor %eax,%eax 201b00: f3 0f 6f 04 87 movdqu (%rdi,%rax,4),%xmm0 201b05: f3 0f 6f 4c 87 10 movdqu 0x10(%rdi,%rax,4),%xmm1 201b0b: f3 0f 6f 14 86 movdqu (%rsi,%rax,4),%xmm2 201b10: 66 0f fe d0 paddd %xmm0,%xmm2 201b14: f3 0f 6f 44 86 10 movdqu 0x10(%rsi,%rax,4),%xmm0 201b1a: 66 0f fe c1 paddd %xmm1,%xmm0 201b1e: f3 0f 7f 14 82 movdqu %xmm2,(%rdx,%rax,4) 201b23: f3 0f 7f 44 82 10 movdqu %xmm0,0x10(%rdx,%rax,4) 201b29: f3 0f 6f 44 87 20 movdqu 0x20(%rdi,%rax,4),%xmm0 201b2f: f3 0f 6f 4c 87 30 movdqu 0x30(%rdi,%rax,4),%xmm1 201b35: f3 0f 6f 54 86 20 movdqu 0x20(%rsi,%rax,4),%xmm2 201b3b: 66 0f fe d0 paddd %xmm0,%xmm2 201b3f: f3 0f 6f 44 86 30 movdqu 0x30(%rsi,%rax,4),%xmm0 201b45: 66 0f fe c1 paddd %xmm1,%xmm0 201b49: f3 0f 7f 54 82 20 movdqu %xmm2,0x20(%rdx,%rax,4) 201b4f: f3 0f 7f 44 82 30 movdqu %xmm0,0x30(%rdx,%rax,4) 201b55: 48 83 c0 10 add $0x10 ,%rax 201b59: 49 83 c2 02 add $0x2 ,%r10 201b5d: 75 a1 jne 201b00 <_Z3sumPiS_S_i+0xf0> 201b5f: 41 f6 c1 01 test $0x1 ,%r9b 201b63: 74 29 je 201b8e <_Z3sumPiS_S_i+0x17e> 201b65: f3 0f 6f 04 87 movdqu (%rdi,%rax,4),%xmm0 201b6a: f3 0f 6f 4c 87 10 movdqu 0x10(%rdi,%rax,4),%xmm1 201b70: f3 0f 6f 14 86 movdqu (%rsi,%rax,4),%xmm2 201b75: 66 0f fe d0 paddd %xmm0,%xmm2 201b79: f3 0f 6f 44 86 10 movdqu 0x10(%rsi,%rax,4),%xmm0 201b7f: 66 0f fe c1 paddd %xmm1,%xmm0 201b83: f3 0f 7f 14 82 movdqu %xmm2,(%rdx,%rax,4) 201b88: f3 0f 7f 44 82 10 movdqu %xmm0,0x10(%rdx,%rax,4) 201b8e: 4c 39 c1 cmp %r8,%rcx 201b91: 0f 85 8b fe ff ff jne 201a22 <_Z3sumPiS_S_i+0x12> 201b97: c3 retq 201b98: 31 c0 xor %eax,%eax 201b9a: 41 f6 c1 01 test $0x1 ,%r9b 201b9e: 75 c5 jne 201b65 <_Z3sumPiS_S_i+0x155> 201ba0: eb ec jmp 201b8e <_Z3sumPiS_S_i+0x17e> 201ba2: cc int3 0000000000201bb0 <_Z3kooi>: 201bb0: 8d 47 06 lea 0x6(%rdi),%eax 201bb3: c3 retq
PGO(Profile-Guided Optimization) PGO(Profile-Guided Optimization )也称 FDO(Feedback Directed Optimization),指通过工具采集程序运行时的 profile 数据,用以在重新编译流程中优化程序。
FDO 的方案普遍被大厂用于优化数据中心的应用
TiFlash 中支持 PGO:PR#5160
根据 llvm/docs/profile-guided-optimization ,LLVM 的 PGO 主要分为 2 种:
代码插桩(Profiling with Instrumentation )
增加编译参数 -fprofile-instr-generate
运行特定的 benchmark 负载,令程序自动采集 profile 数据(缺点是程序运行较慢)
使用 llvm-profdata merge 将一个或多个 .profraw 转换为 .profdata
重新编译时指定 profile 数据 -fprofile-instr-use=<xxx.profdata>
运行时采样(Using Sampling Profilers )
增加编译参数 -gline-tables-only -fdebug-info-for-profiling -funique-internal-linkage-names
正常部署运行程序,利用 Linux perf
在支持 LBR(Last Branch Record)的平台上,可用 -j/--branch-filter 采集 branch stack;它不是普通的函数调用栈
利用 AutoFDO 将 perf 数据转换为 LLVM 格式的 profile 数据
重新编译时指定 profile 数据 -fprofile-sample-use=<profile.prof>
一个完整的插桩式 PGO 最小流程如下:
1 2 3 4 clang++ -O2 -fprofile-instr-generate app.cpp -o app.instrumented LLVM_PROFILE_FILE="app-%p.profraw" ./app.instrumented <benchmark-args> llvm-profdata merge -o app.profdata app-*.profraw clang++ -O2 -fprofile-instr-use=app.profdata app.cpp -o app.pgo
即使只有一个 .profraw,也需要执行 llvm-profdata merge 完成格式转换。多进程或多轮负载应使用不会互相覆盖的文件名,并合并所有具有代表性的 profile。
采样现有进程、采样整个系统和直接启动工作负载是三种不同范围,不应把 -p 和 -a 混在同一条命令里:
1 2 3 perf record -p <pid> -e cycles:up -j any,u -o perf.data -- sleep 180 sudo perf record -a -e cycles:up -j any,u -o perf.data -- sleep 180 perf record -e cycles:up -j any,u -o perf.data -- <executable> <args> ...
事件修饰符 p 请求更精确的硬件采样,并非所有 CPU 都支持;遇到 event syntax error 或 precise event 不可用时,可退回 cycles:u。-j any,u 同样依赖处理器的分支记录能力以及系统的 perf 权限配置。
1 create_llvm_prof --profile <perf.data> --binary <binary> --out=<profile.prof>
如果存在稳定且具有代表性的 benchmark,插桩式 PGO 通常可以获得更精确的 profile;如果希望从真实线上负载采集数据,并尽量降低运行开销,则可以采用采样式 PGO。两者应根据负载代表性、采集成本和部署条件选择。
案例(7.0) 该案例中虚函数 Extend::foo 被调用的频率明显高于 Base::foo,正常的 O3 优化可以按照一定的步长展开循环,但无法在运行时预测分支。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 #include <chrono> #include <cstdio> #include <vector> struct Base { virtual void foo (int & x) { x += -1 ; } virtual ~Base () = default ; }; struct Extend : Base{ void foo (int & x) override { x += 1 ; } }; int main () std::vector<Base> a; std::vector<Extend> b; std::vector<Base *> c; { for (int i = 0 ; i < 100 ; ++i) { a.emplace_back (Base{}); for (int j = 0 ; j < 100 ; ++j) { b.emplace_back (Extend{}); } } for (auto & x : a) c.emplace_back (&x); for (auto & x : b) c.emplace_back (&x); } auto start = std::chrono::steady_clock::now (); { int res = 0 ; for (int i = 0 ; i < 100000 ; ++i) for (auto & x : c) { x->foo (res); } std::printf ("%d\n" , res); } auto end = std::chrono::steady_clock::now (); std::printf ("time cost %lld ms\n" , std::chrono::duration_cast <std::chrono::milliseconds>(end - start).count ()); }
1 2 3 4 clang++ ./fdo-test.cpp -O3 -Wl,--no-rosegment -gline-tables-only -fdebug-info-for-profiling -funique-internal-linkage-names -o ori.out -flto=thin -fvisibility=hidden -fvisibility-inlines-hidden -fwhole-program-vtables -fsplit-lto-unit -DNDEBUG -fuse-ld=lld '-Rpass=.*' >pass.ori 2>&1 perf record -e cycles:up -j any,u -o test-perf.data -- ./ori.out create_llvm_prof --profile test-perf.data --binary ./ori.out --out=test.prof clang++ ./fdo-test.cpp -O3 -Wl,--no-rosegment -gline-tables-only -fdebug-info-for-profiling -funique-internal-linkage-names -flto=thin -fvisibility=hidden -fvisibility-inlines-hidden -fwhole-program-vtables -fsplit-lto-unit -DNDEBUG -o fdo.out -fprofile-sample-use=./test.prof -fuse-ld=lld '-Rpass=.*' >pass.new 2>&1
这里的 --no-rosegment 来自 LLVM 13/LLD 的历史实验配置,不是所有新版工具链都必须使用的通用 PGO 参数。采集 profile 的二进制必须与 create_llvm_prof --binary 指向的文件一致,并保留匹配的 build ID、符号和调试行表。
FDO 优化效果:编译器根据虚函数调用频率执行 Promote indirect call 优化,实现去虚拟化。
2012d8: 对比虚函数地址和 <_ZN6Extend3fooERi> 函数地址是否相同
2012de: 如果比较相同则直接跳转到 2012c0
2012c0: 内联实现 <_ZN6Extend3fooERi>
1 2 3 4 5 6 7 ./ori.out 990000000 time cost 2688 ms ./fdo.out 990000000 time cost 2581 ms
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 ./fdo-test.cpp:48:20: Promote indirect call to _ZN6Extend3fooERi with count 63471 out of 64151 ... 201293: e8 48 08 00 00 callq 201ae0 <_ZNSt3__16chrono12steady_clock3nowEv@plt> 201298: 49 89 c6 mov %rax,%r14 20129b: c7 44 24 20 00 00 00 movl $0x0 ,0x20(%rsp) 2012a2: 00 2012a3: 48 8b 2c 24 mov (%rsp),%rbp 2012a7: 48 8b 5c 24 08 mov 0x8(%rsp),%rbx 2012ac: 48 39 dd cmp %rbx,%rbp 2012af: 0f 84 ec 00 00 00 je 2013a1 <main+0x471> 2012b5: 45 31 ff xor %r15d,%r15d 2012b8: 4c 8d 64 24 20 lea 0x20(%rsp),%r12 2012bd: eb 0a jmp 2012c9 <main+0x399> 2012bf: 90 nop 2012c0: 83 44 24 20 01 addl $0x1 ,0x20(%rsp) 2012c5: 48 83 c5 08 add $0x8 ,%rbp 2012c9: 48 39 dd cmp %rbx,%rbp 2012cc: 74 1d je 2012eb <main+0x3bb> 2012ce: 48 8b 7d 00 mov 0x0(%rbp),%rdi 2012d2: 48 8b 07 mov (%rdi),%rax 2012d5: 48 8b 00 mov (%rax),%rax 2012d8: 48 3d 10 1a 20 00 cmp $0x201a10 ,%rax 2012de: 74 e0 je 2012c0 <main+0x390> 2012e0: 4c 89 e6 mov %r12,%rsi 2012e3: ff d0 callq *%rax 2012e5: 48 83 c5 08 add $0x8 ,%rbp 2012e9: eb de jmp 2012c9 <main+0x399> 2012eb: 41 83 c7 01 add $0x1 ,%r15d 2012ef: 41 81 ff a0 86 01 00 cmp $0x186a0 ,%r15d 2012f6: 74 0b je 201303 <main+0x3d3> 2012f8: 48 8b 2c 24 mov (%rsp),%rbp 2012fc: 48 8b 5c 24 08 mov 0x8(%rsp),%rbx 201301: eb c6 jmp 2012c9 <main+0x399> 201303: 8b 74 24 20 mov 0x20(%rsp),%esi 201307: bf af 0a 20 00 mov $0x200aaf ,%edi 20130c: 31 c0 xor %eax,%eax 20130e: e8 dd 07 00 00 callq 201af0 <printf @plt> 201313: e8 c8 07 00 00 callq 201ae0 <_ZNSt3__16chrono12steady_clock3nowEv@plt> ... 0000000000201a10 <_ZN6Extend3fooERi>: 201a10: ff 06 incl (%rsi) 201a12: c3 retq ...
案例(7.1)
详见 tiflash#5160
TiFlash 以 commit 5b61ae70550624d3bf0b5ca6bac89013ed5a6a4b 为例
测试工具为 go-tpc ,并以 TPC-H 负载用于 perf 采样和优化验证
单节点 TPC-H 10G 数据通过 cgroup 限制程序最多使用 5 核
1 2 3 mkdir -p /sys/fs/cgroup/cpu/pgo_testlsof -i:9000 | grep 'TiFlash' | grep -v 'grep' | awk '{print $2}' > /sys/fs/cgroup/cpu/pgo_test/cgroup.procs echo "500000" > /sys/fs/cgroup/cpu/pgo_test/cpu.cfs_quota_us
测试结果显示,对于重计算的场景例如 Q1,FDO+LTO 比起 LTO 的性能提升为 8.98%,相对于未做任何优化的版本提升 13.46%。Q13、Q18 之类的查询也因为聚合/过滤等计算占比较大获得一定的收益。而其他查询受计算模式中资源调度、数据瓶颈等因素影响存在一定的波动,优化效果不如 Q1 那么明显。
下表的提升比例按 基线耗时 / 优化后耗时 - 1 计算,表示等效 speedup,而非耗时下降比例。表中结果未展示多次运行的方差;对于执行时间较短或差异较小的查询,结果可能受到调度、缓存和系统负载影响,应通过多次运行的中位数及离散程度进一步验证。
Time Cost(s)
original
LTO
FDO+LTO
FDO+LTO : LTO
FDO+LTO : original
Q1
6.32
6.07
5.57
8.98%
13.46%
Q2
2.99
2.99
2.92
2.40%
2.40%
Q3
2.79
2.65
2.65
0.00%
5.28%
Q4
1.91
2.05
1.85
10.81%
3.24%
Q6
0.91
0.91
0.84
8.33%
8.33%
Q7
2.38
2.32
2.32
0.00%
2.59%
Q8
4.8
4.73
4.73
0.00%
1.48%
Q9
16.81
16.54
16.48
0.36%
2.00%
Q10
3.72
3.72
3.66
1.64%
1.64%
Q11
0.5
0.5
0.5
0.00%
0.00%
Q12
1.98
1.91
1.85
3.24%
7.03%
Q13
4.66
4.6
4.33
6.24%
7.62%
Q14
1.04
1.11
0.97
14.43%
7.22%
Q15
2.05
1.98
2.11
-6.16%
-2.84%
Q16
1.04
1.04
0.97
7.22%
7.22%
Q17
5.67
5.8
5.67
2.29%
0.00%
Q18
8.62
8.41
7.99
5.26%
7.88%
Q19
3.12
3.05
3.05
0.00%
2.30%
Q20
1.58
1.58
1.64
-3.66%
-3.66%
Q21
2.99
2.85
2.89
-1.38%
3.46%
Q22
0.64
0.64
0.5
28.00%
28.00%
3 节点跑 TPCH-100,限制每个节点 CPU 使用上限 1000%,结果如下
Time Cost(s)
LTO
FDO+LTO
FDO+LTO : LTO
Q1
12.08
11.04
9.42%
Q2
4.33
4.26
1.64%
Q3
8.22
8.09
1.61%
Q4
21.17
21.64
-2.17%
Q5
19.36
19.83
-2.37%
Q6
1.91
1.85
3.24%
Q7
9.83
9.97
-1.40%
Q8
11.98
11.58
3.45%
Q9
65.26
64.32
1.46%
Q10
10.57
10.37
1.93%
Q11
2.05
2.05
0.00%
Q12
5.2
5.27
-1.33%
Q13
12.72
12.11
5.04%
Q14
2.18
2.11
3.32%
Q15
4.13
4.06
1.72%
Q16
2.32
2.25
3.11%
Q17
18.29
18.22
0.38%
Q18
23.12
22.85
1.18%
Q19
5.87
5.74
2.26%
Q20
4.06
4.13
-1.69%
Q21
39.02
39.29
-0.69%
Q22
1.38
1.31
5.34%
除了 Q1,其他查询或多或少涉及到资源调度和等待,测试过程中无法全程打满 CPU,提升效果不如 Q1 那么明显。
Post-link Optimizer BOLT BOLT(Binary Optimization and Layout Tool) 是 LLVM 中的 Post-link Optimizer。它根据 perf 等工具采集的运行 profile,分析最终 ELF 二进制中的函数地址、基本块和跳转关系,再重新排列代码布局。因为 BOLT 工作在链接完成之后,所以能看到编译器和链接器处理后的实际地址与最终布局。
案例(8.0) 假设某个服务的请求处理路径如下:
1 2 3 4 5 6 7 8 9 10 bool handleRequest (Request & request) if (!parseRequest (request)) return reportParseError (request); if (!authenticate (request)) return reportAuthError (request); if (request.isQuery ()) return executeQuery (request); return executeRareCommand (request); }
生产负载中,parseRequest、authenticate 和 executeQuery 几乎被每个请求调用,而错误处理和其他命令很少执行。链接后的函数仍可能分散在不同地址:
1 2 3 4 5 6 7 0x1000 handleRequest hot 0x1800 reportParseError cold 0x2400 executeRareCommand cold 0x5000 parseRequest hot 0x6800 reportAuthError cold 0x9000 authenticate hot 0xb000 executeQuery hot
正常查询需要在多个相距较远的地址间跳转:
1 0x1000 -> 0x5000 -> 0x9000 -> 0xb000
BOLT 根据真实分支轨迹把热函数集中排列,并将冷函数移到远处:
1 2 3 4 5 6 7 8 0x1000 handleRequest hot 0x1100 parseRequest hot 0x1400 authenticate hot 0x1800 executeQuery hot 0x9000 reportParseError cold 0x9200 reportAuthError cold 0x9500 executeRareCommand cold
优化后的常见路径更加紧凑:
1 0x1000 -> 0x1100 -> 0x1400 -> 0x1800
这个过程通常不改变算法,而是通过函数重排、基本块重排和冷热代码分离,降低指令 Cache miss、iTLB miss 和取指停顿。BOLT 也可以在单个函数内部将低频错误处理和异常路径拆到冷区。
按照当前 BOLT README ,正式使用前还要确认以下前提:
输入是 x86-64 或 AArch64 ELF,并且至少保留未剥离的符号表;保留 relocation 才能获得完整的函数重排能力。
GCC 8 及以上默认可能启用 BOLT 不兼容的 -freorder-blocks-and-partition,因此使用 GCC 构建输入文件时应显式增加 -fno-reorder-blocks-and-partition。
perf 的 branch stack 是高质量基本块 profile 的主要来源。硬件或虚拟机不支持 branch stack 时可以只采样地址,并向 perf2bolt 增加 -ba,但 profile 精度和预期收益都会下降。profile 应尽量来自同一份二进制和代表性负载。BOLT 虽能容忍一定差异,但报告中的 stale function 越多,profile 越不可信;release 分支应重新采集。
默认不会重写完整调试信息;确实需要调试优化后二进制时,应评估 -update-debug-sections 的额外处理成本并验证调试体验。
BOLT 的基本使用流程如下。首先在最终链接时保留 relocation:
1 2 clang++ -O3 -g -Wl,--emit-relocs ... -o application readelf -SW ./application | grep -E '\.rela?\.text'
使用具有代表性的负载采集分支信息,并转换为 BOLT profile:
1 2 perf record -e cycles:u -j any,u -o perf.data -- ./application <args> perf2bolt -p perf.data -o perf.fdata ./application
最后优化二进制:
1 2 3 4 5 6 7 8 9 llvm-bolt ./application \ -o ./application.bolt \ -data=perf.fdata \ -reorder-blocks=ext-tsp \ -reorder-functions=cdsort \ -split-functions \ -split-all-cold \ -split-eh \ -dyno-stats
运行优化后二进制的 smoke test 和回归测试,还应记录 llvm-bolt --version、perf --version、输入二进制校验和、profile 采集命令和 stale profile 统计,避免把不同 BOLT 版本或不同二进制的结果混在一起。
BOLT 与 LTO 、PGO 不是替代关系,可以继续优化已经经过 PGO 和 ThinLTO 处理的二进制。LLVM 官方构建流程也支持组合使用 PGO、ThinLTO 和 BOLT,详见 LLVM Advanced Build Configurations 。
代码大页 代码大页是独立于 Post-link Optimizer 的操作系统内存管理机制。BOLT 的 -hugify 是一种自动化实现,程序也可以通过 madvise 或定制 Loader 手动处理代码大页。
假设热代码占 32 MiB,使用 4 KiB 普通页需要 8192 个页,而使用 2 MiB 大页只需 16 个页,理论上可以显著降低热代码的 iTLB 压力。
BOLT -hugify BOLT 将热代码集中到连续区域后,可以通过 -hugify 请求使用 Transparent Huge Pages(THP):
1 2 3 4 5 6 7 8 9 10 llvm-bolt ./application \ -o ./application.bolt \ -data=perf.fdata \ -reorder-blocks=ext-tsp \ -reorder-functions=cdsort \ -split-functions \ -split-all-cold \ -split-eh \ -hugify \ -dyno-stats
BOLT main 分支的 hugify runtime 会识别热代码区间,按 2 MiB 边界处理,并通过 MADV_HUGEPAGE 请求 THP。该实现没有调用 MADV_COLLAPSE:在较新的文件 THP 路径上,它还会检查全局 THP 模式是否为 always 或 madvise。因此,当系统把 THP 全局设置为 never 时,不能假设 -hugify 会像手动 MADV_COLLAPSE 一样绕过该策略;必须以目标 BOLT 版本的源码、运行日志和 smaps 为准。
案例(8.1):在 THP 上执行一个返回 42 的函数 在操作真实 ELF 代码段之前,可以先用一个微型 JIT 风格的案例验证代码大页机制。程序申请一块 2 MiB 对齐的匿名内存,写入一段“返回 42”的机器码,请求 THP,然后将内存权限从 RW 改成 RX 并执行。这个案例只支持 Linux x86-64 和 AArch64。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 #ifndef _GNU_SOURCE #define _GNU_SOURCE #endif #include <cstdint> #include <cstdio> #include <cstdlib> #include <cstring> #include <sys/mman.h> #include <unistd.h> namespace { constexpr std::size_t huge_page_size = 2 * 1024 * 1024 ;std::uintptr_t alignUp (std::uintptr_t value, std::size_t alignment) return (value + alignment - 1 ) & ~(alignment - 1 ); } void * mapAlignedHugePageCandidate () constexpr std::size_t total_size = huge_page_size * 2 ; void * raw = mmap ( nullptr , total_size, PROT_READ | PROT_WRITE, MAP_PRIVATE | MAP_ANONYMOUS, -1 , 0 ); if (raw == MAP_FAILED) { std::perror ("mmap" ); std::exit (EXIT_FAILURE); } const auto raw_begin = reinterpret_cast <std::uintptr_t >(raw); const auto raw_end = raw_begin + total_size; const auto aligned_begin = alignUp (raw_begin, huge_page_size); const auto aligned_end = aligned_begin + huge_page_size; const std::size_t prefix_size = aligned_begin - raw_begin; const std::size_t suffix_size = raw_end - aligned_end; if (prefix_size != 0 && munmap (reinterpret_cast <void *>(raw_begin), prefix_size) != 0 ) { std::perror ("munmap prefix" ); std::exit (EXIT_FAILURE); } if (suffix_size != 0 && munmap (reinterpret_cast <void *>(aligned_end), suffix_size) != 0 ) { std::perror ("munmap suffix" ); std::exit (EXIT_FAILURE); } return reinterpret_cast <void *>(aligned_begin); } void writeReturn42 (void * memory) #if defined(__x86_64__) const unsigned char code[] = { 0xb8 , 0x2a , 0x00 , 0x00 , 0x00 , 0xc3 , }; std::memcpy (memory, code, sizeof (code)); #elif defined(__aarch64__) const std::uint32_t code[] = { 0x52800540 , 0xd65f03c0 , }; std::memcpy (memory, code, sizeof (code)); #else #error "This example supports only x86-64 and AArch64" #endif __builtin___clear_cache( static_cast <char *>(memory), static_cast <char *>(memory) + huge_page_size); } void printMappingInfo (void * address) FILE * file = std::fopen ("/proc/self/smaps" , "r" ); if (file == nullptr ) { std::perror ("fopen /proc/self/smaps" ); return ; } const auto target = reinterpret_cast <std::uintptr_t >(address); char line[512 ]; bool found = false ; while (std::fgets (line, sizeof (line), file) != nullptr ) { unsigned long begin = 0 ; unsigned long end = 0 ; if (std::sscanf (line, "%lx-%lx" , &begin, &end) == 2 ) { if (found) break ; found = target >= begin && target < end; if (found) std::printf ("mapping: %s" , line); continue ; } if (!found) continue ; if (std::strncmp (line, "Size:" , 5 ) == 0 || std::strncmp (line, "KernelPageSize:" , 15 ) == 0 || std::strncmp (line, "MMUPageSize:" , 12 ) == 0 || std::strncmp (line, "AnonHugePages:" , 14 ) == 0 || std::strncmp (line, "Private_Hugetlb:" , 16 ) == 0 || std::strncmp (line, "Shared_Hugetlb:" , 15 ) == 0 || std::strncmp (line, "THPeligible:" , 12 ) == 0 || std::strncmp (line, "VmFlags:" , 8 ) == 0 ) std::printf ("%s" , line); } std::fclose (file); } } int main () void * memory = mapAlignedHugePageCandidate (); std::printf ("mapping address: %p, size: 2 MiB\n" , memory); if (madvise (memory, huge_page_size, MADV_HUGEPAGE) != 0 ) std::perror ("MADV_HUGEPAGE" ); else std::puts ("MADV_HUGEPAGE accepted" ); std::memset (memory, 0 , huge_page_size); writeReturn42 (memory); #ifdef MADV_COLLAPSE if (madvise (memory, huge_page_size, MADV_COLLAPSE) != 0 ) { std::perror ("MADV_COLLAPSE" ); std::puts ("waiting for khugepaged" ); sleep (15 ); } else { std::puts ("MADV_COLLAPSE succeeded" ); } #else std::puts ("MADV_COLLAPSE is unavailable; waiting for khugepaged" ); sleep (15 ); #endif if (mprotect (memory, huge_page_size, PROT_READ | PROT_EXEC) != 0 ) { std::perror ("mprotect RX" ); return EXIT_FAILURE; } using Function = int (*)(); auto function = reinterpret_cast <Function>(memory); const int result = function (); std::printf ("hello from executable memory, result = %d\n" , result); printMappingInfo (memory); munmap (memory, huge_page_size); return result == 42 ? EXIT_SUCCESS : EXIT_FAILURE; }
编译并运行:
1 2 clang++ -std=c++17 -O2 -Wall -Wextra thp_code_hello.cpp -o thp_code_hello ./thp_code_hello
运行前可以确认系统 THP 模式和 PMD 大页大小:
1 2 3 4 cat /sys/kernel/mm/transparent_hugepage/enabledcat /sys/kernel/mm/transparent_hugepage/hpage_pmd_sizecat /sys/kernel/mm/transparent_hugepage/khugepaged/scan_sleep_millisecscat /sys/kernel/mm/transparent_hugepage/khugepaged/alloc_sleep_millisecs
理想结果中,函数返回 42,且 smaps 显示:
1 2 hello from executable memory, result = 42 AnonHugePages: 2048 kB
MADV_HUGEPAGE 返回成功仅表示内核接受建议。THPeligible: 1 也只表示该 VMA 有资格尝试 THP,只有 AnonHugePages 大于 0 才能证明当前确实映射了匿名 PMD THP。如果 AnonHugePages 仍为 0,可能是 THP 被禁用、MADV_COLLAPSE 不可用、khugepaged 尚未完成合并,或者受到内存碎片、NUMA 和 cgroup 限额影响。khugepaged 是全局扫描器;即使等待时间超过 scan_sleep_millisecs 和 alloc_sleep_millisecs,也不保证目标 VMA 已经被扫描并成功合并。因此固定 sleep 只能提供观察窗口,不能构成确定性验证。若需要同步、尽力触发合并,应在 Linux 6.1 及以上使用 MADV_COLLAPSE;若要求映射成功即确定使用大页,则需要显式 HugeTLB。如果 mprotect 返回 EACCES,则可能是 SELinux、容器或其他安全策略禁止匿名可执行内存。
这个案例演示的是 JIT 风格的匿名可执行代码,目的在于隔离验证代码大页机制;它不会把现有 ELF 的 .text 自动搬到大页上。下一节再讨论如何为真实 ELF 热点代码建立独立 section。
手动请求 THP 下面给出一个完整的 ELF 实验模板。它把一个热点函数放入 2 MiB 对齐的 .hottext,程序启动后对该区间调用 MADV_HUGEPAGE,并在可用时调用 MADV_COLLAPSE。模板可以独立编译和运行,但目标内核不支持文件 THP 时,预期结果就是 THPeligible: 0 和 FilePmdMapped: 0 kB,不能把“程序运行成功”写成“代码大页成功”。
该案例针对 Linux 上常见的 2 MiB PMD THP。它故意把 .hottext 补足到 2 MiB,以便稳定观察映射结果,因此会显著增大实验二进制;生产环境不应为了凑满大页而盲目填充冷代码。
项目只包含两个文件:
1 2 3 manual-thp/ ├── hottext.ld └── manual_thp.cpp
1. 编写增量链接脚本
hottext.ld 内容如下:
1 2 3 4 5 6 7 8 9 10 11 12 SECTIONS { .hottext ALIGN(0x200000) : { __hot_text_start = .; KEEP(*(.hottext)) KEEP(*(.hottext.*)) . = ALIGN(0x200000); __hot_text_end = .; } } INSERT AFTER .text;
为避免 .hottext 被默认的 .text.* 规则提前合并,这里没有使用 .text.hotpage 之类的名称。INSERT AFTER .text 会在默认链接布局中插入新 section,不需要复制和维护整份默认链接脚本;GNU ld 和 lld 都支持这种写法。
KEEP 防止链接器在启用 --gc-sections 时删除输入 section。脚本同时将区间起止地址导出为 __hot_text_start 和 __hot_text_end,供程序运行时使用。
2. 编写完整程序
manual_thp.cpp 内容如下:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 #ifndef _GNU_SOURCE #define _GNU_SOURCE #endif #include <cerrno> #include <cstddef> #include <cstdint> #include <cstdio> #include <cstdlib> #include <cstring> #include <sys/mman.h> #include <unistd.h> extern "C" char __hot_text_start[];extern "C" char __hot_text_end[];extern "C" __attribute__((noinline, used, section (".hottext" )))std::uint64_t hotFunction (std::uint64_t value) for (std::uint64_t i = 0 ; i < 1'000'000 ; ++i) { value ^= value << 13 ; value ^= value >> 7 ; value ^= value << 17 ; value += i; } return value; } namespace { constexpr std::uintptr_t huge_page_size = 2 * 1024 * 1024 ;void printMadviseError (const char * operation) const int error = errno; std::fprintf ( stderr, "%s failed: errno=%d (%s)\n" , operation, error, std::strerror (error)); } unsigned char prefaultRange (const char * begin, std::size_t size) const long native_page_size = sysconf (_SC_PAGESIZE); if (native_page_size <= 0 ) { std::perror ("sysconf(_SC_PAGESIZE)" ); std::exit (EXIT_FAILURE); } auto bytes = reinterpret_cast <volatile const unsigned char *>(begin); unsigned char checksum = 0 ; for (std::size_t offset = 0 ; offset < size; offset += static_cast <std::size_t >(native_page_size)) checksum ^= bytes[offset]; return checksum; } } int main () char * const begin = __hot_text_start; char * const end = __hot_text_end; const auto begin_address = reinterpret_cast <std::uintptr_t >(begin); const auto end_address = reinterpret_cast <std::uintptr_t >(end); const std::size_t size = end_address - begin_address; std::printf ( "pid=%ld, .hottext=[%p, %p), size=%zu KiB\n" , static_cast <long >(getpid ()), static_cast <void *>(begin), static_cast <void *>(end), size / 1024 ); if (begin_address % huge_page_size != 0 || end_address % huge_page_size != 0 || size == 0 ) { std::fputs (".hottext is not 2 MiB aligned\n" , stderr); return EXIT_FAILURE; } if (madvise (begin, size, MADV_HUGEPAGE) == 0 ) std::puts ("MADV_HUGEPAGE accepted" ); else printMadviseError ("MADV_HUGEPAGE" ); const unsigned int checksum = prefaultRange (begin, size); std::printf ("prefault checksum=%u\n" , checksum); #ifdef MADV_COLLAPSE if (madvise (begin, size, MADV_COLLAPSE) == 0 ) std::puts ("MADV_COLLAPSE succeeded" ); else printMadviseError ("MADV_COLLAPSE" ); #else std::puts ("MADV_COLLAPSE is unavailable in the system headers" ); #endif const std::uint64_t result = hotFunction (42 ); std::printf ("hotFunction(42)=%llu\n" , static_cast <unsigned long long >(result)); std::puts ("sleeping for 30 seconds; inspect /proc/<pid>/smaps now" ); std::fflush (stdout); sleep (30 ); return EXIT_SUCCESS; }
属性 noinline 防止热点函数被内联到普通 .text,used 防止编译器认为它不需要单独生成。它们只能控制编译阶段,链接脚本中的 KEEP 则处理链接阶段的 section 回收。
3. 编译和链接
使用 GNU ld:
1 2 3 4 5 6 7 8 g++ -std=c++17 -O2 \ -no-pie \ -ffunction-sections -fdata-sections \ manual_thp.cpp \ -Wl,-T,hottext.ld \ -Wl,-z,max-page-size=0x200000 \ -Wl,--gc-sections \ -o manual_thp
使用 Clang 和 lld 时,只需替换编译器并指定 linker:
1 2 3 4 5 6 7 8 clang++ -fuse-ld=lld -std=c++17 -O2 \ -no-pie \ -ffunction-sections -fdata-sections \ manual_thp.cpp \ -Wl,-T,hottext.ld \ -Wl,-z,max-page-size=0x200000 \ -Wl,--gc-sections \ -o manual_thp
实验使用 -no-pie,避免 PIE 加载基址干扰第一次验证。生产环境如果启用 PIE,需要确认内核和动态 Loader 保留 PT_LOAD 的大页对齐,并以程序打印的运行时地址为准。本文后述的 Clang 20 / GNU ld 实机复核中,PIE 版本也保持了 2 MiB 地址和文件偏移对齐,但这只是该工具链与 Loader 组合的结果,不能替代目标环境检查。
-z max-page-size=0x200000 将 ELF PT_LOAD 的最大页对齐提高到 2 MiB,使 .hottext 的虚拟地址和文件偏移有机会同时满足文件 THP 的自然对齐要求。代价是其他 Segment 之间也可能产生较大空洞,令实验二进制明显增大。
4. 链接后静态检查
先检查 section:
1 readelf -SW ./manual_thp | grep -E '\.(text|hottext)'
.hottext 应带有 AX 标志,Address 和 Off 都应按 2 MiB 对齐,Size 应为 0x200000 或其整数倍。然后检查 Program Header:
1 readelf -lW ./manual_thp
确认 .hottext 位于具有 R E 权限的 LOAD Segment 中,并且该 Segment 的 Align 为 0x200000。如果虚拟地址对齐但文件偏移没有对齐,文件映射仍不满足 THP 条件。
5. 运行并检查实际映射
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 ./manual_thp & pid=$! sleep 2awk -v exe="$(readlink -f ./manual_thp) " ' /^[0-9a-f]+-[0-9a-f]+/ { show = ($2 ~ /r-x/ && $NF == exe) if (show) print next } show && /^(KernelPageSize|MMUPageSize|FilePmdMapped|AnonHugePages|THPeligible|VmFlags):/ { print } ' /proc/${pid} /smapswait ${pid}
这个案例操作的是 ELF 文件支持的可执行映射,因此主要成功信号是:
前一个微型 JIT 案例操作的是匿名映射,主要观察 AnonHugePages。两者不能混为一谈。Linux 内核文档也分别使用 FilePmdMapped 和 AnonHugePages 统计这两类 THP,详见 Transparent Hugepage Support 。
6. 为什么仍可能失败
MADV_HUGEPAGE 返回成功只表示内核接受建议,不代表已经生成 THP。对于普通文件支持的映射,还需要满足以下条件:
内核启用了 CONFIG_TRANSPARENT_HUGEPAGE 和 CONFIG_READ_ONLY_THP_FOR_FS。
映射具有可执行权限,底层文件没有以写方式打开。
虚拟地址与文件内偏移都在 THP 边界上自然对齐。
VMA 没有被标记为 VM_NOHUGEPAGE,进程也没有完全禁用 THP。
内存、NUMA 和 cgroup 条件允许内核分配并合并大页。
先检查运行内核的构建配置;发行版内核未必开放 /proc/config.gz,也可能只在 /boot 保留配置:
1 2 zgrep -E 'CONFIG_(TRANSPARENT_HUGEPAGE|READ_ONLY_THP_FOR_FS)' /proc/config.gz 2>/dev/null \ || grep -E 'CONFIG_(TRANSPARENT_HUGEPAGE|READ_ONLY_THP_FOR_FS)' /boot/config-"$(uname -r) "
即使配置项存在,也要以当前 VMA 的 THPeligible 和 FilePmdMapped 为最终运行时证据。
MADV_COLLAPSE 从 Linux 6.1 开始提供,会同步、尽力尝试合并当前映射。它不依赖 /sys/kernel/mm/transparent_hugepage 下的全局策略,但仍可能因为内核不支持文件 THP、映射不合格、内存不足或 cgroup 限额而失败。完整语义和错误码见 madvise(2)
此外,开启 LTO 后,编译器仍可能克隆或重写函数;支持 ICF 的链接器也可能折叠内容相同的函数。实验时应通过符号表和 section 表确认最终布局,不能只相信源码中的属性。
这个案例验证的是“为特定 ELF 文件映射建立对齐布局并请求 THP”的完整路径。只有 FilePmdMapped 大于 0 时,才能进一步说目标代码当前位于文件 THP 上;即使映射成功,也不代表实际性能一定提升。生产程序还需要用真实 profile 选择热点代码,并对比 iTLB miss、IPC、RSS、二进制大小和启动时间。
显式 HugeTLB 如果要求“映射成功后一定使用大页”,则需要预留显式 HugeTLB,并通过 MAP_HUGETLB 创建代码映射:
1 2 3 4 5 6 7 8 9 10 #include <linux/mman.h> #include <sys/mman.h> void * memory = mmap ( nullptr , size, PROT_READ | PROT_WRITE, MAP_PRIVATE | MAP_ANONYMOUS | MAP_HUGETLB | MAP_HUGE_2MB, -1 , 0 );
映射成功后,需要写入已经完成 relocation 的代码,再通过 mprotect 把权限从 RW 改成 RX。普通 ELF 的 .text 中可能包含 PC-relative 引用、GOT/PLT、跳转表和异常展开信息,不能简单复制到新地址执行,因此现有程序通常需要定制 Loader 或运行时支持。当前 BOLT 上游的显式 HugeTLB 支持仍在改进讨论中,详见 BOLT hugify improvements 。
统一验证与性能对照 “系统支持大页”“madvise 返回成功”和“目标代码当前确实映射在大页上”是三个不同状态。最终应根据映射类型检查 /proc/<pid>/smaps:
匿名 THP,例如微型 JIT:AnonHugePages
文件支持的可执行 THP,例如 .hottext:FilePmdMapped
显式 HugeTLB:Private_Hugetlb 或 Shared_Hugetlb
实机复核环境为 Rocky Linux 9.2、Linux 5.14.0、Clang 20.1.8、GNU ld 2.35.2 和 LLD 20.1.8;系统 THP 模式为 always,PMD 大页为 2 MiB。结果如下:
测试
布局或执行结果
smaps 结果结论
匿名 JIT
2 MiB 对齐,代码成功返回 42
THPeligible: 1,等待 70 秒后仍为 AnonHugePages: 0 kB请求路径和可执行内存有效,但该次运行没有获得匿名 THP;异步扫描未命中或合并条件未满足
GNU ld、no-PIE .hottext
地址 0x800000、文件偏移 0x400000、大小 2 MiB,函数运行成功
THPeligible: 0,FilePmdMapped: 0 kBELF 对齐成功,目标内核不接受该文件映射使用 THP
GNU ld、PIE .hottext
运行时地址与文件偏移保持 2 MiB 对齐,函数运行成功
THPeligible: 0,FilePmdMapped: 0 kB该环境证明 PIE 可以保持对齐,但仍没有文件 THP
LLD、no-PIE .hottext
地址 0x600000、文件偏移 0x200000、大小 2 MiB,函数运行成功
THPeligible: 0,FilePmdMapped: 0 kBLLD 布局有效,目标内核仍不支持该映射
该内核早于 Linux 6.1,采集器对 MADV_COLLAPSE 的能力探测返回 EINVAL;内核配置采集中也没有出现已启用的 CONFIG_READ_ONLY_THP_FOR_FS。这些结果说明链接布局正确只是必要条件,不能据此宣称代码已使用大页。BOLT 工具在该环境中未安装,因此这次复核不覆盖 -hugify。
下面的命令显示指定可执行文件的所有可执行映射及其大页统计:
1 2 3 4 5 6 7 8 9 10 11 awk -v exe="$(readlink -f ./application) " ' /^[0-9a-f]+-[0-9a-f]+/ { show = ($2 ~ /r-x/ && $NF == exe) if (show) print next } show && /^(KernelPageSize|MMUPageSize|FilePmdMapped|AnonHugePages|Private_Hugetlb|Shared_Hugetlb|THPeligible|VmFlags):/ { print } ' /proc/<pid>/smaps
映射验证通过后,再在相同二进制、负载、CPU 绑定、NUMA 策略和预热条件下比较性能:
1 2 3 4 perf stat \ -e cycles,instructions,iTLB-loads,iTLB-load-misses \ -p <pid> \ -- sleep 180
至少应对比普通页、THP 和(如实际部署允许)显式 HugeTLB,并同时记录查询延迟、吞吐、IPC、iTLB miss、RSS、二进制大小和启动时间。仅看到 FilePmdMapped: 2048 kB 不能证明业务性能一定提升。
jemalloc 能否直接用于代码大页 不能。jemalloc 的 opt.thpopt.metadata_thp 控制分配器内部元数据;它们可以影响堆和 jemalloc 元数据,但不会重新布局或替换 ELF Loader 创建的代码段映射。
例如下面的配置可以用于评估 jemalloc 管理的内存是否适合 THP,但不会令 .text 或 .hottext 自动使用代码大页:
1 MALLOC_CONF="thp:always,metadata_thp:auto" ./application
如果程序通过 jemalloc 的自定义 extent hooks 自行管理 JIT 代码内存,可以在 hooks 中实现特定映射策略;这属于应用自定义的可执行内存管理,不是 jemalloc 对普通 ELF 代码段的直接支持。
本文尚未完成代码大页在 TiFlash 上的严格对照实验,因此不评价实际收益。后续应在相同负载和构建配置下,分别比较原始版本、PGO + ThinLTO、PGO + ThinLTO + BOLT,以及 PGO + ThinLTO + BOLT + -hugify。
编译缓存 ccache 作为一种编译器缓存用于加速重编译过程。tiflash/cmake/find_ccache.cmake 也默认开启这一优化项来加速 CI 流程。C++ 的特性决定了头文件耦合程度会大幅影响编译缓存命中率,所以问题的核心又回到了 头文件优化 。
根据当前 ccache - Precompiled headers 文档,ccache 配合 PCH 使用时需要设置 sloppiness=pch_defines,time_macros;Clang 还应增加 -fno-pch-timestamp,避免 PCH 时间戳令缓存失效。
就目前而言,ccache 主要用于日常开发以及 Pull Request 的 CI 流程(增量编译),PCH 则主要用于 release 编译(全量编译)。
本次优化中,限制模板实例化使两个典型编译单元的前端耗时分别下降约 89%;启用 PCH 后,前端累计耗时由 7181.8 秒下降至 4167.5 秒,降幅约 42%。由于两次分析包含的编译任务数略有差异,这些数据应视为工程效果的近似对照,最终收益仍需以相同环境下的墙钟时间验证。
社区|新开发者如何参与优化
根据 tiflash/README.md 中的指示部署基本编译环境。
设置 CMake 选项:
-DENABLE_TIME_TRACES=ON 开启编译分析追踪-DUSE_CCACHE=OFF 禁用 ccache-DENABLE_PCH=OFF 禁用 PCH(目前先专注于优化头文件相关的开销)-DCMAKE_BUILD_TYPE=RelWithDebInfo 或 -DCMAKE_BUILD_TYPE=Debug 需分别优化两种编译模式下的各项指标
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 cd ${TIFLASH_BUILD} CC=clang CXX=clang++ cmake \ -S ${TIFLASH_WORKSPACE} \ -DCMAKE_BUILD_TYPE=RelWithDebInfo \ -DLINKER_NAME=lld \ -DUSE_CCACHE=0 \ -DENABLE_TIME_TRACES=ON \ -DENABLE_PCH=0 \ -Wno-dev \ -DNO_WERROR=ON \ -GNinja time cmake --build . --target tiflash --parallel 5
编译后在 ${TIFLASH_BUILD} 中可获取每个目标文件的编译期火焰图
参考 编译流程分析 编译部署 ClangBuildAnalyzer ,并用其分析 ${TIFLASH_BUILD}
保存 ClangBuildAnalyzer 生成的中间文件和分析结果,作为对照组
根据 ClangBuildAnalyzer 分析结果,找出瓶颈点,参照上文进行优化
CMAKE_EXPORT_COMPILE_COMMANDS 默认开启,可在文件 ${TIFLASH_BUILD}/compile_commands.json 中找到各个编译单元的执行命令。
每次修改后,找到关联源文件的编译命令并手动执行,分析编译时的火焰图
可安装 include-what-you-use 后用 iwyu_tool.py 辅助。其中存在误报,需人工排查。
例如 iwyu_tool.py -p ${TIFLASH_BUILD} ${TIFLASH_WORKSPACE}/dbms/src/Storages/Transaction/TMTContext.cpp
优化目标
降低 clean build 的实际墙钟时间和累计 CPU 时间
降低常见代码修改触发的增量构建时间
避免少数超大编译单元成为并行构建的长尾任务
降低不必要的模板实例化和头文件传递依赖
提高 ccache 命中率,并控制编译峰值内存
在不牺牲代码可维护性的前提下优化构建效率
参考文档